Marx Max 可以用作计量经济学课堂上的演示与练习工作台。AI 进课堂,下一次讲 OLS,你准备怎么用?把需求讨论、代码与计算结果放在同一处,教师就能从一个模型出发,展示结果,再围绕学生的问题改变条件。公式中的抽象关系,也就有了可观察、可比较的内容。
为了减少研究者在讨论、写代码和看结果之间的切换,我们把对话和计算放进了同一个工作区。左侧讨论当前问题,右侧保留可检查、可修改的代码与输出。这种安排同样适合教学:先看一次估计,再比较不同样本;先解释一条回归,再讨论它支持什么判断。AI 协助实现计算,教师决定例子要回答的问题,以及哪些条件值得改变。
下面三个例子依次展开 OLS 抽样分布、回归系数的经济解释和 MCMC 后验抽样。第一例用 Python 建立已知真值的参照,第二例转向 Stata 的实际数据,第三例比较同一模型下的抽样算法。教师把问题与比较条件写成需求,交给 Marx Max 中的 AI 生成并运行代码,再结合输出展开讨论。每例都给出一段提示词;文中的数值与图表提供对应计算的参照,配套代码见文末。
例子一:OLS 的估计值为什么随样本变化
一次估计偏离真值,意味着什么?
如果模型中的真实斜率是 2,为什么回归没有恰好得到 2?这个问题适合从模拟开始:我们知道数据怎样生成,也知道参数真值,因此可以把真实关系与估计结果画在同一张图上。设
其中解释变量与误差相互独立,各观察也独立。要把这个模型变成可比较的图,可以向 AI 提出这样的需求:
请用 Python 展示 OLS 的抽样波动。按 生成数据, 与 独立且均服从标准正态分布,各观察独立,随机数种子用 42。先生成 30 个观察,估计回归,画出散点、真实直线和拟合线;再分别以 30 和 300 个观察重复抽样 500 次,比较斜率估计的分布。请生成并运行代码,将两部分画在同一张图中,标明真值,并保留代码与实际计算结果。
这一需求把模型、变化条件和图中的对照对象交代清楚,AI 就可以据此完成数据生成、估计与绘图。文末配套实现中,30 个观察的拟合线约为
图中的散点围绕真实直线分布,拟合线则由当前样本决定。斜率 1.854 与真值 2 的差距,并不能证明 OLS 有偏:无偏性讨论的是重复抽样下的期望,不要求每份样本的估计值都等于真值。把这两条线同时呈现,能让“参数”“估计值”和“拟合关系”各有明确对象。
从公式看抽样波动的来源
将数据生成式代入含截距的 OLS 斜率公式,可以得到
右侧第二项就是这份样本中估计偏离真值的部分。误差的条件均值为零,不意味着有限样本中的加权误差和也恰好为零;重新抽取观察,分子与分母都会改变。因此,一次偏离与估计量无偏并不矛盾。模拟图把这种关系具体化:样本改变,散点改变,拟合线随之改变,而数据生成规则没有改变。
这里还可以区分真实误差与拟合残差。前者是生成数据时加入的 ,后者是 ,取决于估计出来的直线。模拟允许同时查看两者;实际数据通常只能观察残差,不能把残差直接当成已知的真实误差。
样本量改变的是估计分布
保持同一生成机制,分别以 30 和 300 个观察重复抽样 500 次,每次重新生成数据并估计斜率。此时比较的对象从一条拟合线变成了估计值的分布:参数保持不变,样本在变化。
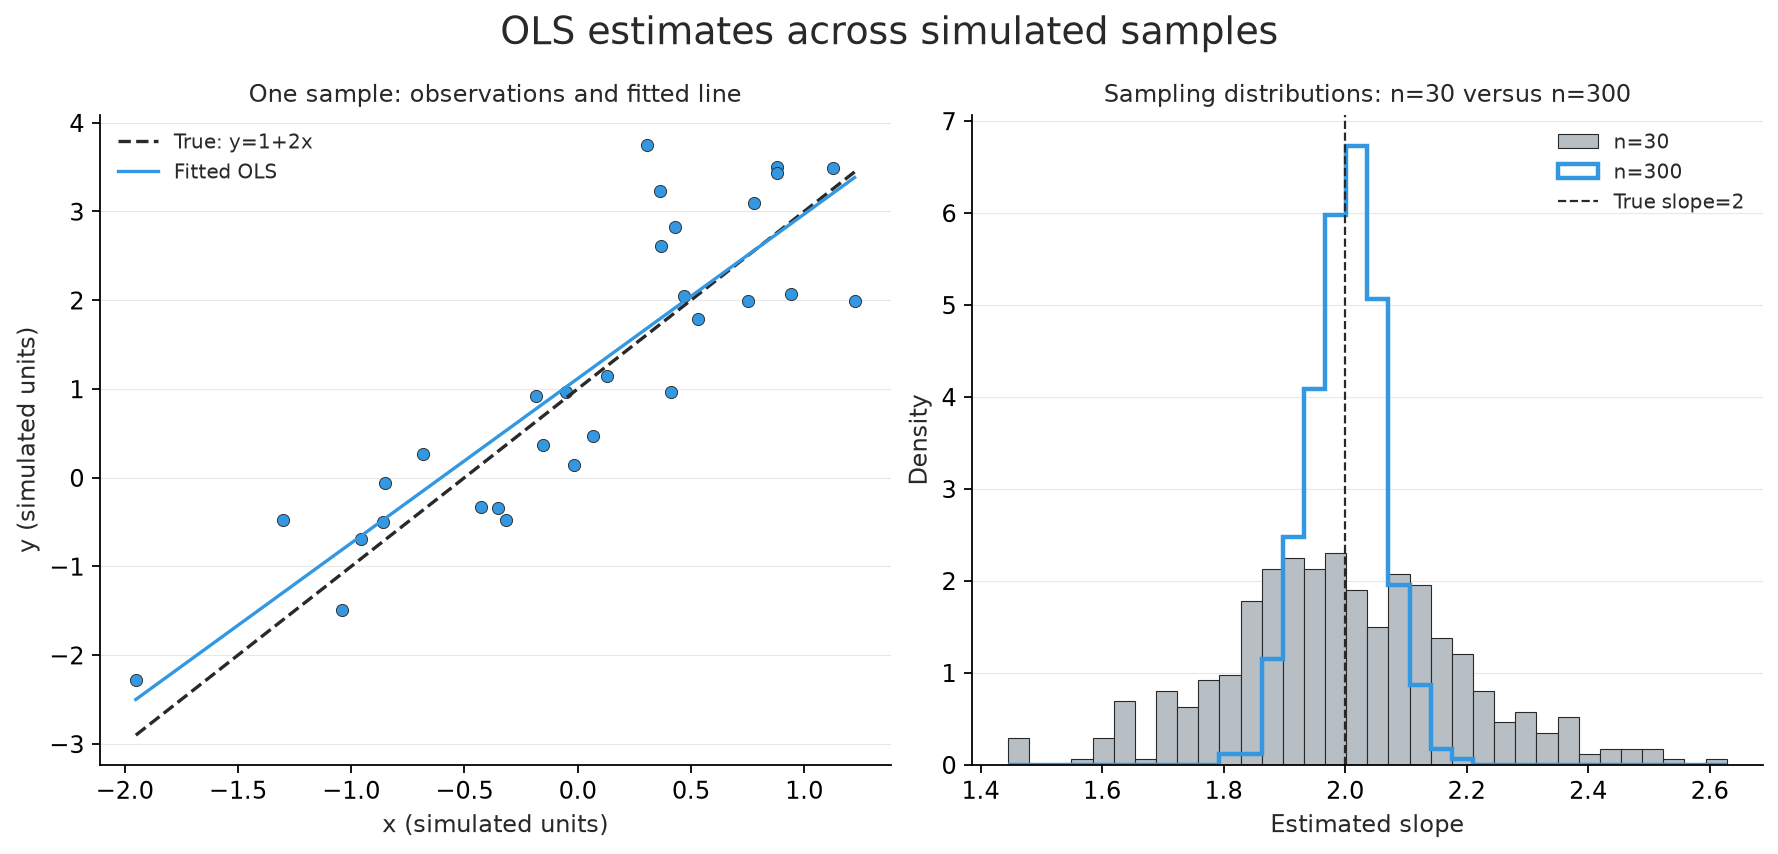
图 1:左图比较一份样本中的真实关系与 OLS 拟合线;右图展示重复抽样得到的斜率分布。较大样本的分布更集中,但单次估计仍可能偏离真值。
本次结果中,两组斜率均值约为 1.997 和 2.001,标准差约为 0.192 和 0.059。两组分布都围绕 2,而较大样本的波动明显较小。这比只展示一次“大样本估计更接近 2”更有解释力:样本量影响的是抽样分布,不能保证任意一份大样本都比任意一份小样本更准确。
这一对照也为进一步讨论提供了明确起点。保持样本量不变、增大误差方差,分布会怎样变化?让解释变量与误差相关,估计还会围绕 2 吗?前一个问题涉及精度,后一个涉及模型条件。把它们放在同一个可修改的计算例子里,学生能看到“波动更大”和“偏离真值”并非同一种问题,增加样本也不能自动修复后者。
例子二:解读回归系数
从一条负系数走向经济解释
第一例知道真值,第二例则面对实际数据。Stata 的 auto 数据包含 1978 年的 74 个车型;用价格对燃油效率回归,得到的 mpg 系数约为 −238.89。这个方向值得讨论:燃油效率越高,拟合价格反而越低,它描述了怎样的车型差异?
这次可以直接让 AI 调用 Stata 完成回归,并围绕负系数组织解释:
请用 Stata 自带的 auto 数据运行
reg price mpg,保留原始数据文件,展示实际回归输出和所用命令。结合 price 与 mpg 的单位,把系数写成拟合关系,并比较 20 mpg 与 30 mpg 对应的拟合价格。围绕“为什么燃油效率较高的车型,拟合价格反而较低”提出可能的经济解释,区分回归已经支持的关系与仍需检验的解释;暂不加入其他控制变量。
这样得到的输出既能用于解读系数,也保留了后续比较的基础。下面是这条回归的结果:
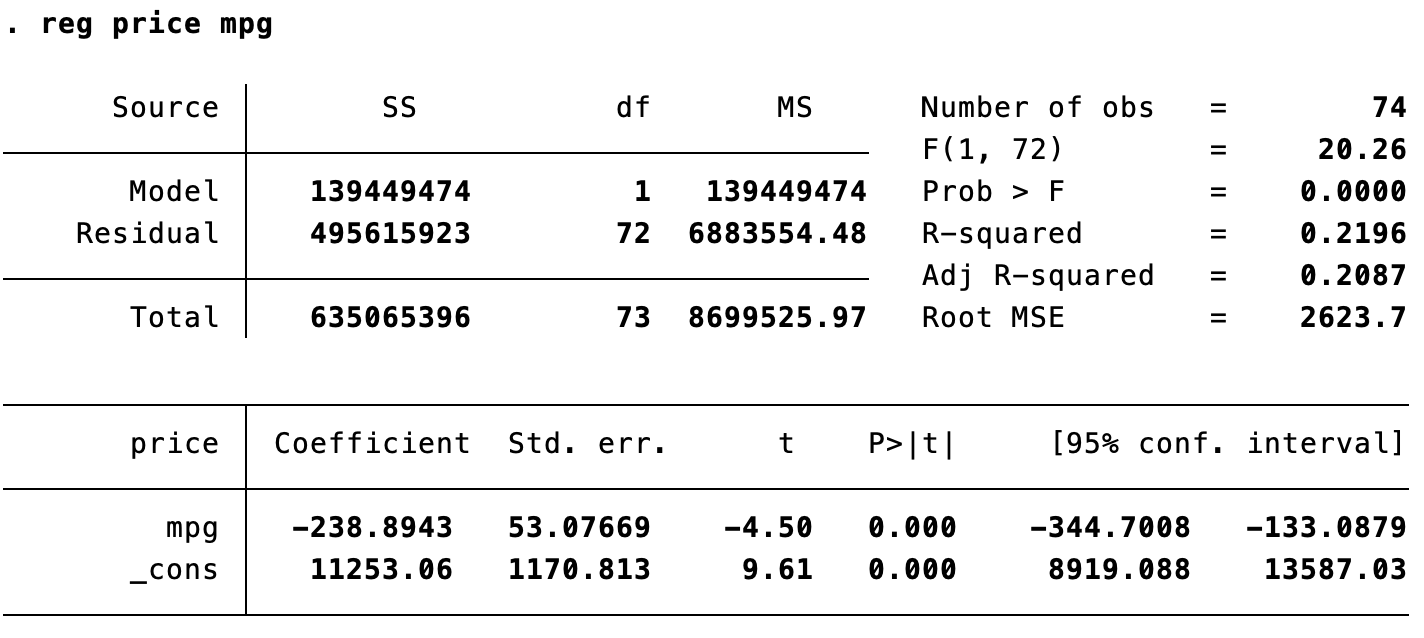
图 2:汽车价格与燃油效率的一元回归呈现负向关系。回归表提供系数及其不确定性;这一关系的经济解释仍需要考虑车型之间的其他差异。
将输出还原为拟合关系,系数就不再只是表格中的一个数字:
price 以美元计,mpg 以英里/加仑计。因此,沿拟合线增加 10 个 mpg 单位,对应约 2388.94 美元的价格差。20 mpg 与 30 mpg 的拟合价格分别约为 6475.17 和 4086.23 美元。这两个点将斜率转换成可讨论的数量关系,却没有回答“把同一辆车改得更省油,会不会使它降价”。模型比较的是不同车型;重量、尺寸、配置与市场定位等差异可能同时与价格和燃油效率有关。
一个显著的关系,怎样形成有根据的解释?
输出中的置信区间约为 ,支持当前推断设定下的负向关系。但区间没有包含零,并不会替我们选择经济机制。一种可能是更小、更轻的车型通常更省油,也处于不同的价格区间;这需要用数据继续检验,不能把可能解释写成这条回归已经证明的结论。
这个例子可以沿着同一问题继续:加入重量之后,mpg 系数怎样变化?如果加入的变量存在缺失,比较的车型是否也变了?只有同时核对变量设定与有效样本,才能分辨系数变化可能来自哪一部分。控制变量不是为了让回归表更丰富,而是对应一个明确的比较条件;即使加入重量,也不能仅凭系数变化就认定因果关系已经得到识别。
因此,第二例最有价值的内容是从“看见负系数”推进到“提出解释并设计比较”。Marx Max 可以保留基础回归的代码与结果,再围绕同一问题展开后续计算,方便将不同设定并排核对。教师无需逐项复述回归表的栏目定义,而可以让学生说明:当前结果支持哪句话,哪句话还需要补充依据,以及下一条回归究竟要检验什么。
例子三:MCMC 怎样近似后验分布
数据不变,抽样的对象变了
第三例沿用第一例的 30 个观察,但不再重新生成研究数据。第一例观察估计量在重复抽样中的变化,这里则在给定数据后推断参数。为集中展示 MCMC,固定截距与误差标准差,只把斜率作为未知参数:
先验方差为 25,即标准差为 5。在这个设定下,正态似然与正态先验给出可直接计算的后验,因此我们可以用解析分布核对 MCMC。选择有解析解的模型,是为了看清算法怎样工作:目标分布已知,抽样近似与目标之间的差异就能被单独观察。
可以把模型与所需的对照一起交给 AI,让它生成抽样程序和图:
请沿用第一例的 30 个观察,用 Python 比较同一个斜率后验下的随机游走 Metropolis。固定截距和误差标准差为 1,斜率先验为 ,其中 25 是方差。先求解析后验作为参照,再分别使用 0.01、0.35 和 3 的提议标准差;各链从 0 开始,种子均为 42,运行 5000 次,拒绝时也保留原状态。请生成并运行代码,将三条轨迹与舍去前 1000 次后的密度画成三行两列,叠加解析密度,使用统一坐标,并报告接受率及保留状态的均值、标准差。
这段需求把统计模型与算法比较分开约定:后验目标保持不变,只改变提议步长。生成图以后,讨论就可以围绕“为什么三条链面对同一个目标,却呈现不同结果”展开。
先确定目标,再理解抽样
后验来自似然与先验的乘积。忽略与 无关的常数,对数后验为
对这个二次式配方,得到
本例后验均值约为 1.853,标准差约为 0.239。它与第一例的 OLS 处理不同:这里固定截距并引入先验,不要求后验均值与原回归完全一致。更重要的是,这个分布描述当前数据与模型条件下的参数不确定性,不是反复生成样本得到的斜率分布。两者都可以画成密度图,但回答的问题不同。
为什么拒绝后还要保留原位置?
采用对称正态随机游走 Metropolis,从当前状态 提出候选值,再按后验密度比决定是否接受:
对称提议使提议密度比抵消,未归一化后验中的公共常数也抵消,因此不必先计算归一化常数。若候选值被拒绝,下一状态仍为 ;轨迹中的水平段正是这种停留。只收集被接受的候选值会丢掉停留时间,改变样本表示的分布,所以拒绝后的重复状态也是抽样结果的一部分。
同一个后验,三种步长
保持数据、先验和初值 0 相同,仅改变提议标准差 ,分别取 0.01、0.35 和 3。三条链各运行 5000 次,右侧密度统一使用舍去前 1000 次后的状态,与解析后验对照。
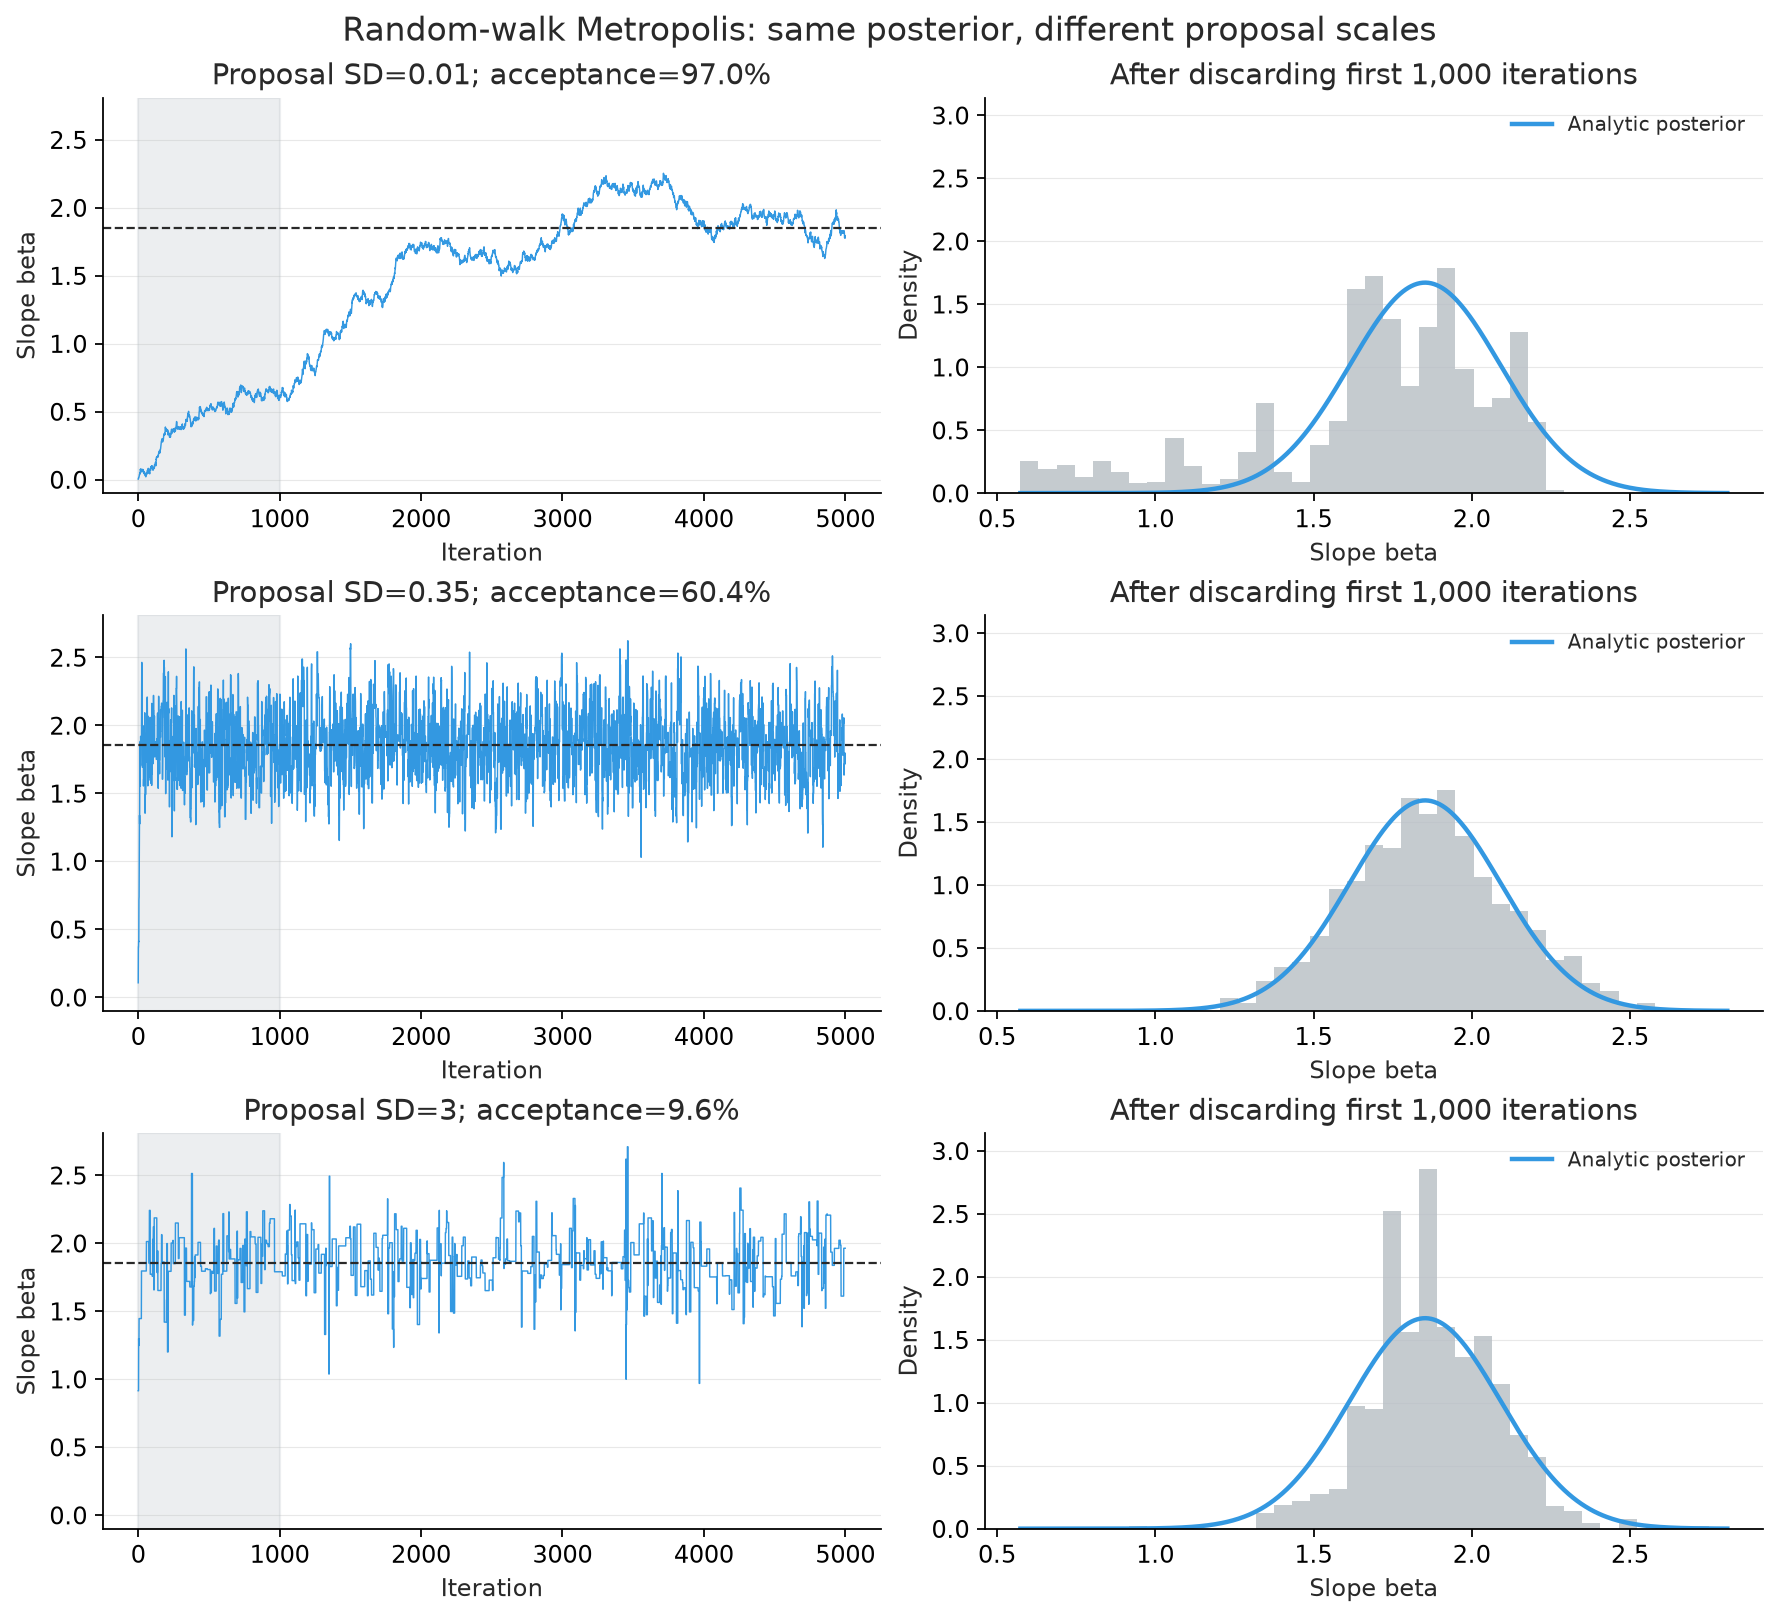
图 3:小步长频繁接受,但探索缓慢;大步长经常拒绝,轨迹出现长时间停留。右列将保留状态的密度与蓝色解析后验比较,展示相同目标下不同抽样效率的影响。
三种步长的接受率约为 97.0%、60.4% 和 9.6%。小步长链虽然接受率最高,保留状态的均值却约为 1.696,与解析均值 1.853 有明显距离;步长 0.35 的均值约为 1.862、标准差约为 0.252,更接近参照。大步长链均值约为 1.872,但标准差约为 0.199,仍与目标的分散程度不同。因此,比较时应同时看轨迹与分布,不能只凭接受率或一个接近的均值判断抽样质量。
这个例子把“目标是否正确”与“有限链是否充分探索”分开了。改变先验会改变目标后验,改变提议步长主要影响探索效率;一条链运行得更久,也不等于获得同样数量的独立样本。舍去前 1000 次只是本例统一的比较安排,正式分析仍需多链与有效样本量等诊断,可参考 Stan 的后验分析说明。
将三个案例连起来
三个例子对应三层理解:OLS 模拟让学生区分一次估计与抽样性质;汽车回归让学生从系数提出经济解释,并思考怎样检验;MCMC 则让学生区分统计目标与计算近似。它们共同要求先明确问题,再确定什么保持不变、什么被改变,最后解释结果。计算能把这些差异呈现出来,教学价值来自差异背后的推理。
Marx Max 在这里提供的是可共同查看和修改的计算工作区。讨论不用与结果分离,改变条件后也可以回到前一次输出比较。把一个案例讲清楚之后再扩展,比一次生成整套分析更容易保持问题、模型与解释的一致性。
配套代码
Python 示例包含 OLS 重复抽样、解析后验与 Metropolis 实现,另保留异方差补充实验;Stata do-file复做汽车回归。模拟统一使用随机数种子 42,图中的结果来自配套代码实际运行。Python 依赖 NumPy 与 Matplotlib;Stata 使用自带 auto 数据。do-file 的 clear 会替换内存中的数据,复做前应保存已有工作。