 复现论文
复现论文
查看案例 →依据论文与相关资料,协助还原数据处理和实证分析流程。核对变量定义、样本筛选与模型设定,编写并运行分析代码,将复现结果与原文对照,梳理差异及其可能原因。适用于经典论文学习、研究方法验证与复现报告整理,保留数据处理步骤、可重跑代码、运行日志和结果表,方便检查、修改与继续研究。
 Marx MaxEN
从数据获取、论文复现到制作 PPT,查看任务要求和成果示例。
复现论文依据论文与相关资料,协助还原数据处理和实证分析流程。核对变量定义、样本筛选与模型设定,编写并运行分析代码,将复现结果与原文对照,梳理差异及其可能原因。适用于经典论文学习、研究方法验证与复现报告整理,保留数据处理步骤、可重跑代码、运行日志和结果表,方便检查、修改与继续研究。
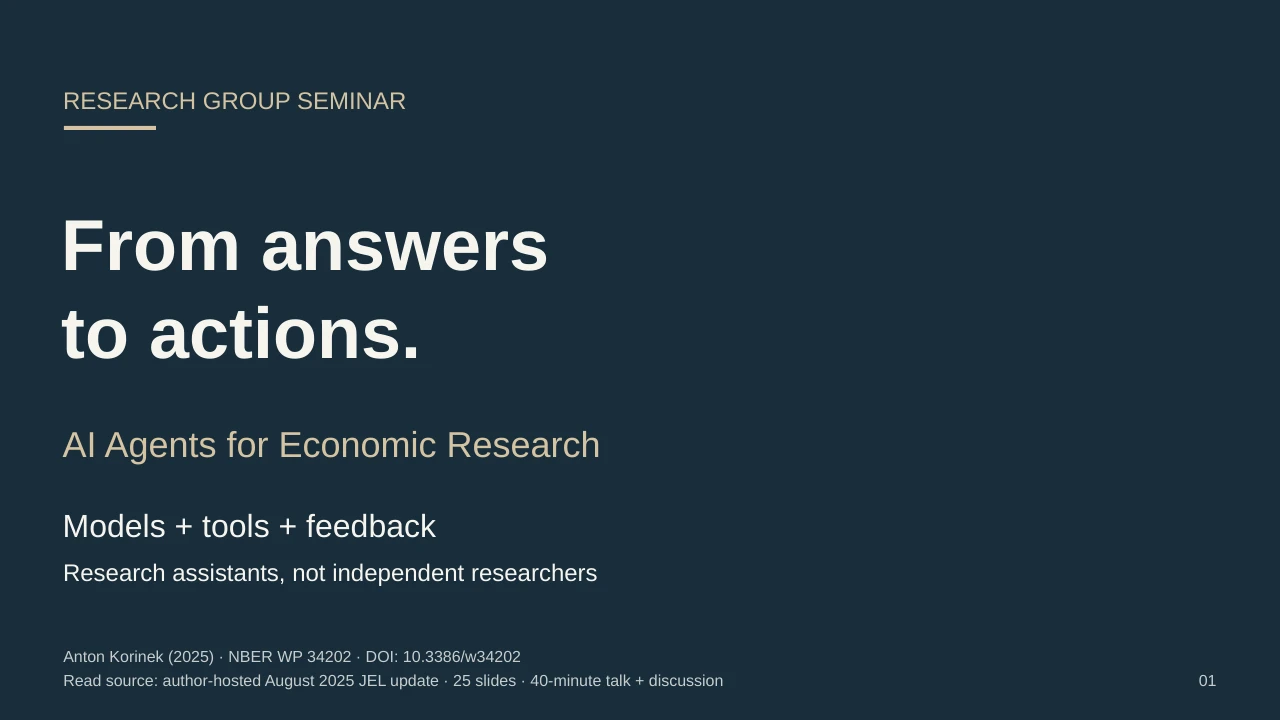
将论文、研究资料或汇报主题整理成清晰的演示文稿。围绕汇报目的、目标受众和时间安排,梳理核心观点、组织讲述顺序,并用简洁文字、图示和版式呈现内容。适用于组会汇报、论文分享与课程展示,可按需要调整页数、语言和视觉风格,输出可编辑的 PPT 和便于分享的 PDF。
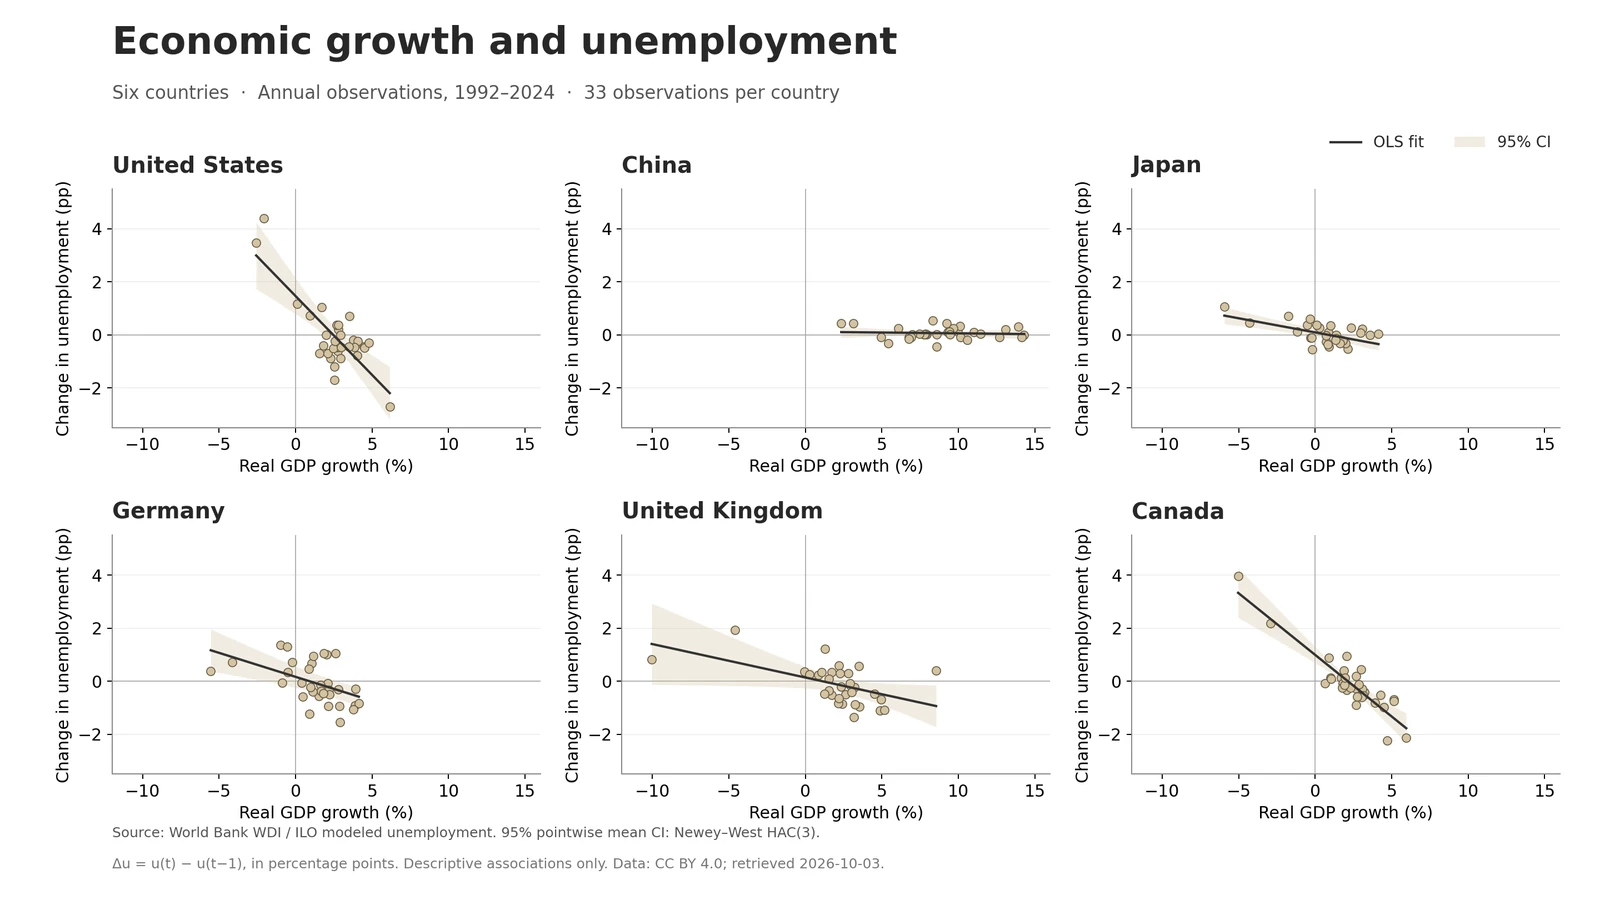
围绕研究问题,从公开数据库中查找并获取所需数据。核对指标定义、统计口径和时间覆盖,完成多指标、多国家与跨年份的数据合并,检查缺失值和重复记录,并用图表直观呈现数据关系。适用于研究起步、数据准备与探索性分析,保留数据来源、变量说明和可重跑代码,整理成便于检查、更新与继续分析的复现包。
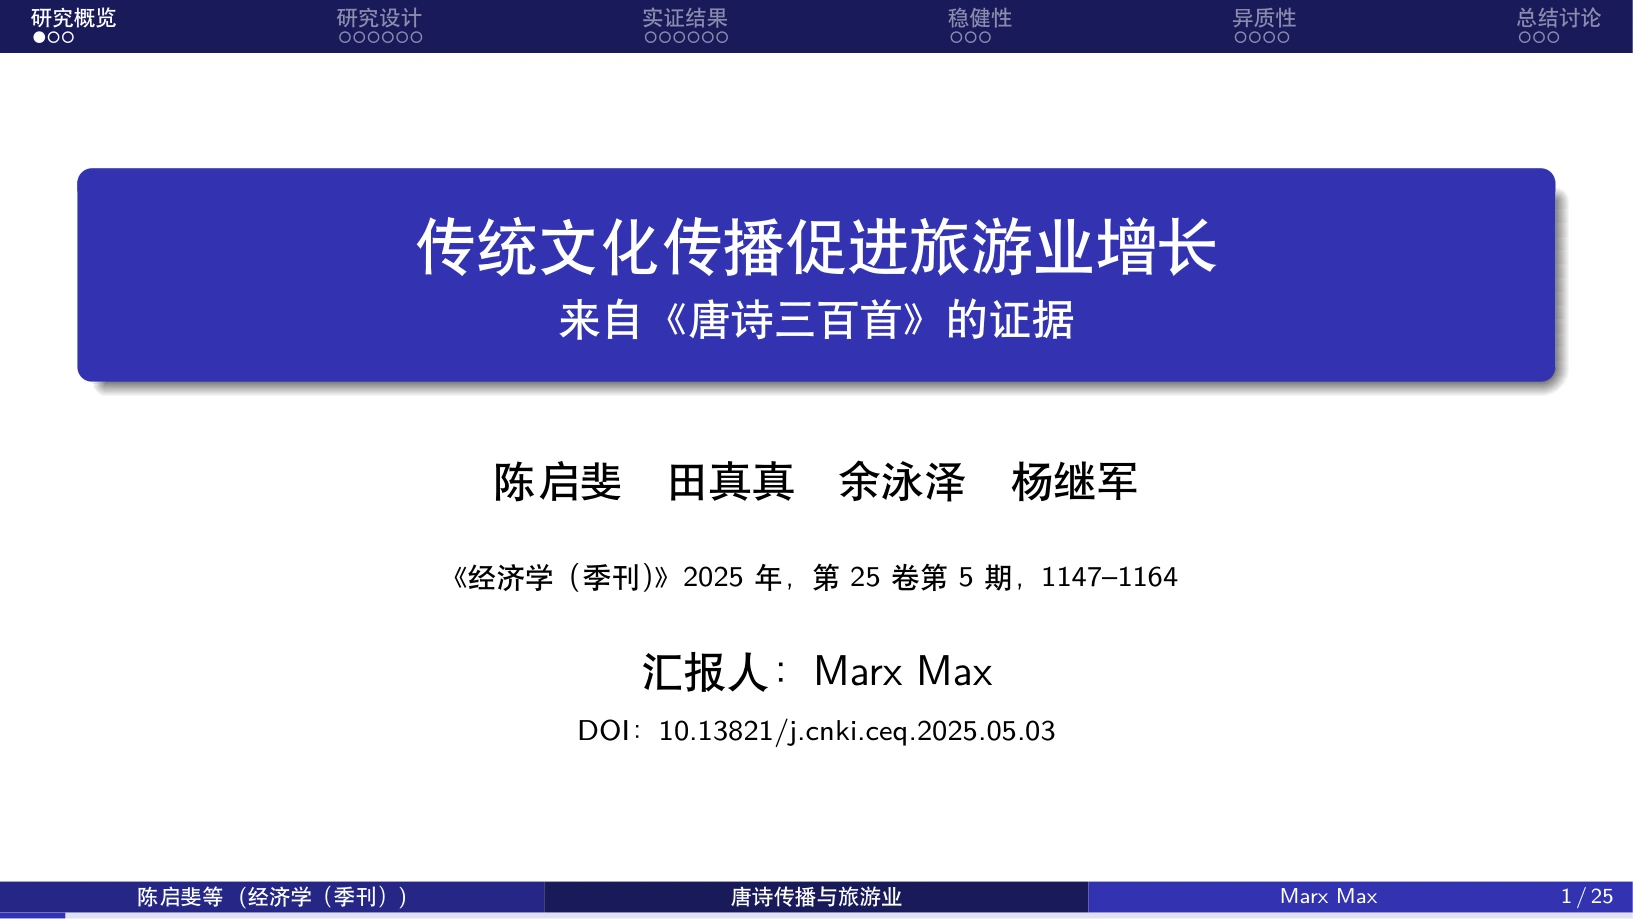
通读论文,梳理研究问题、主要贡献与论证逻辑,将复杂方法、关键公式和结果图表整理成适合讲述的演示文稿。根据听众背景与汇报时长调整重点,保留结论依据,并区分作者观点与汇报者讨论。适用于组会、文献分享和学术交流,提供便于演示的 PDF 和可继续修改的源文件,帮助准备汇报、回应提问与展开讨论。
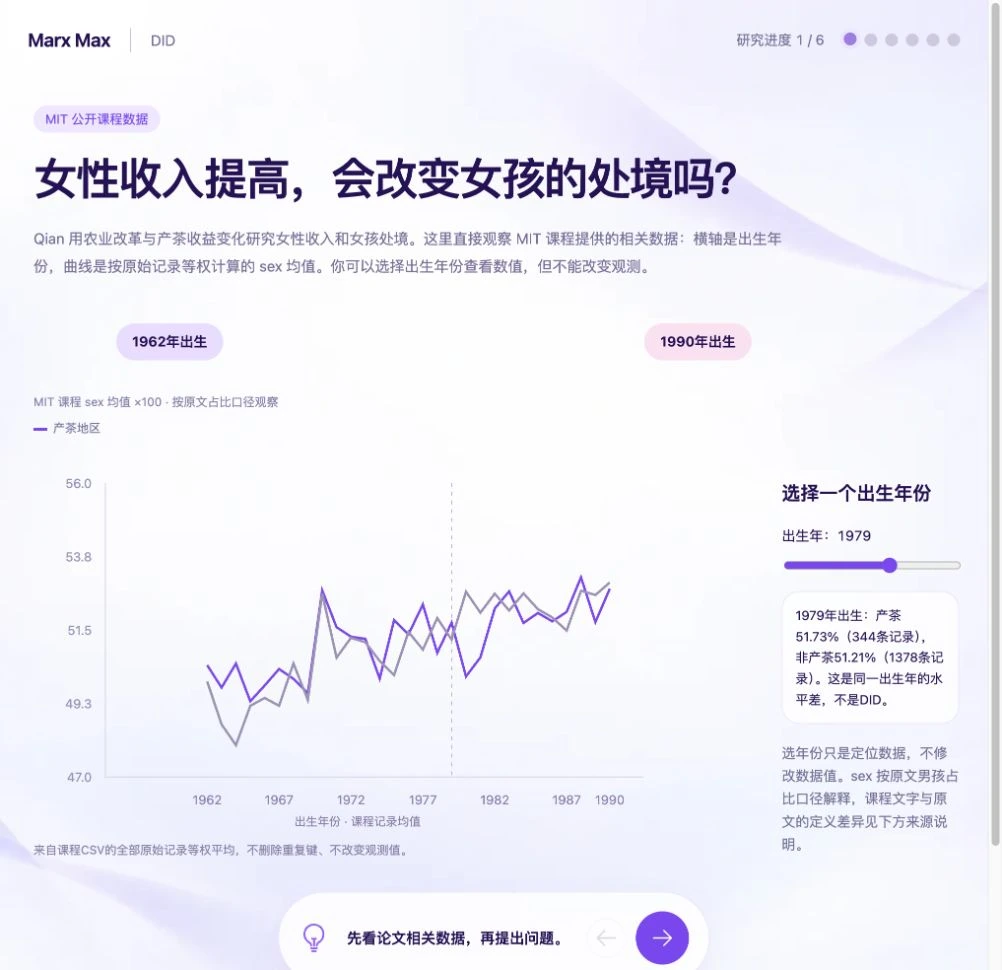
Marx Max 可以围绕论文与研究问题,将抽象的研究方法整理成可交互的学习画布(Canvas)。从读者已有的知识出发,用生活类比、动态图形和可调整的例子解释方法要解决什么问题、如何比较与判断,以及结论成立需要哪些条件。结合论文和数据观察实际应用,通过反例与小练习检验理解,区分教学演示和研究证据。适用于初次接触实证研究、课程学习和论文阅读,生成可在浏览器中打开、保存并继续修改的 HTML,帮助理解方法的逻辑与使用边界。
接入文献数据库通过 OpenAlex 官方 MCP 查找相关论文、查看文献信息,并整理带来源链接的阅读清单。
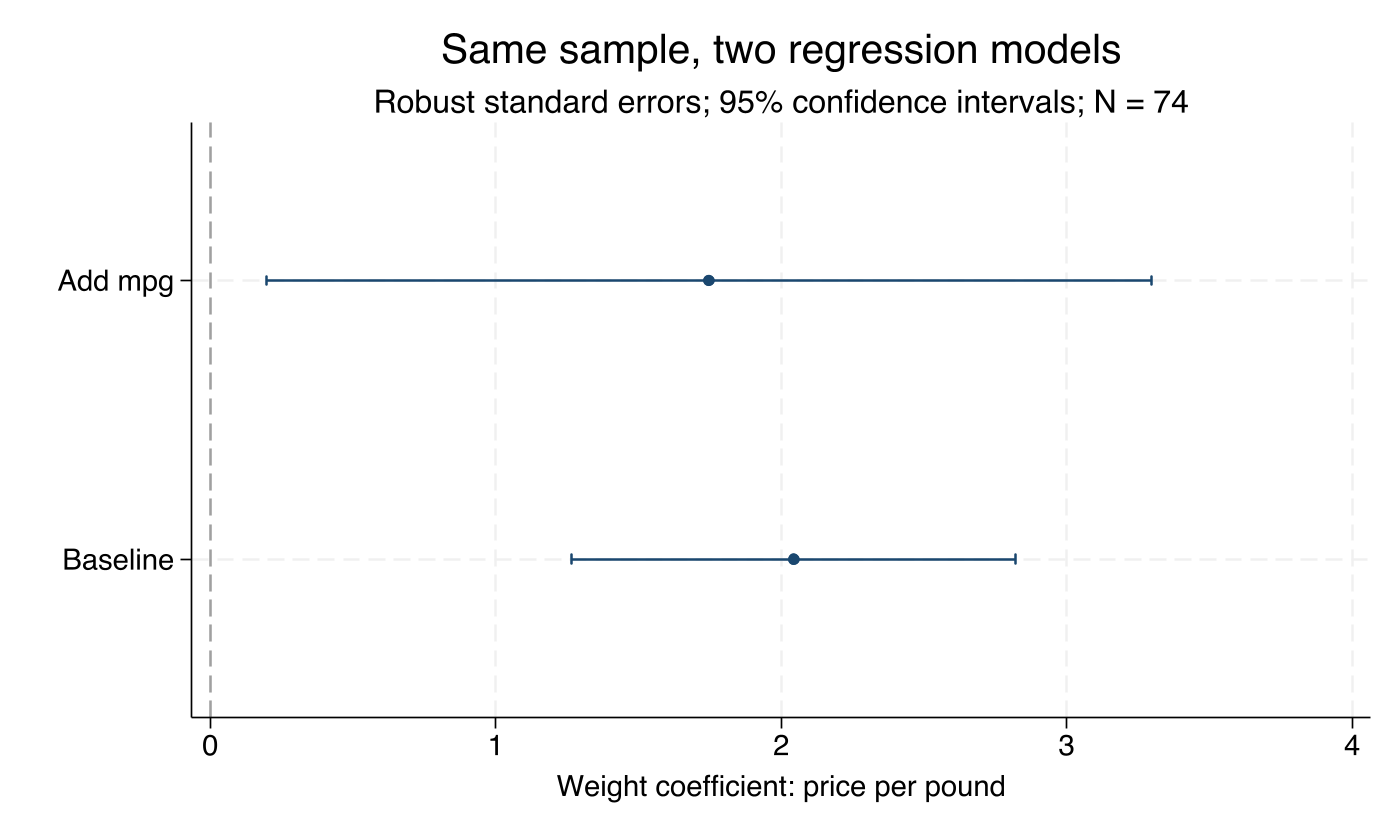
在相同的 74 个观测上比较两个回归模型,核对系数、稳健标准误与区间。查看实际结果和使用指南,下载完整 do-file、CSV、日志及图,按自己的分析问题继续练习。
文献核对从两条真实公开题录开始,核对题名、作者、年份与 DOI,区分文献身份和观点依据。下载 BibTeX、RIS、核对表与阅读记录模板,再按指南准备阅读任务。
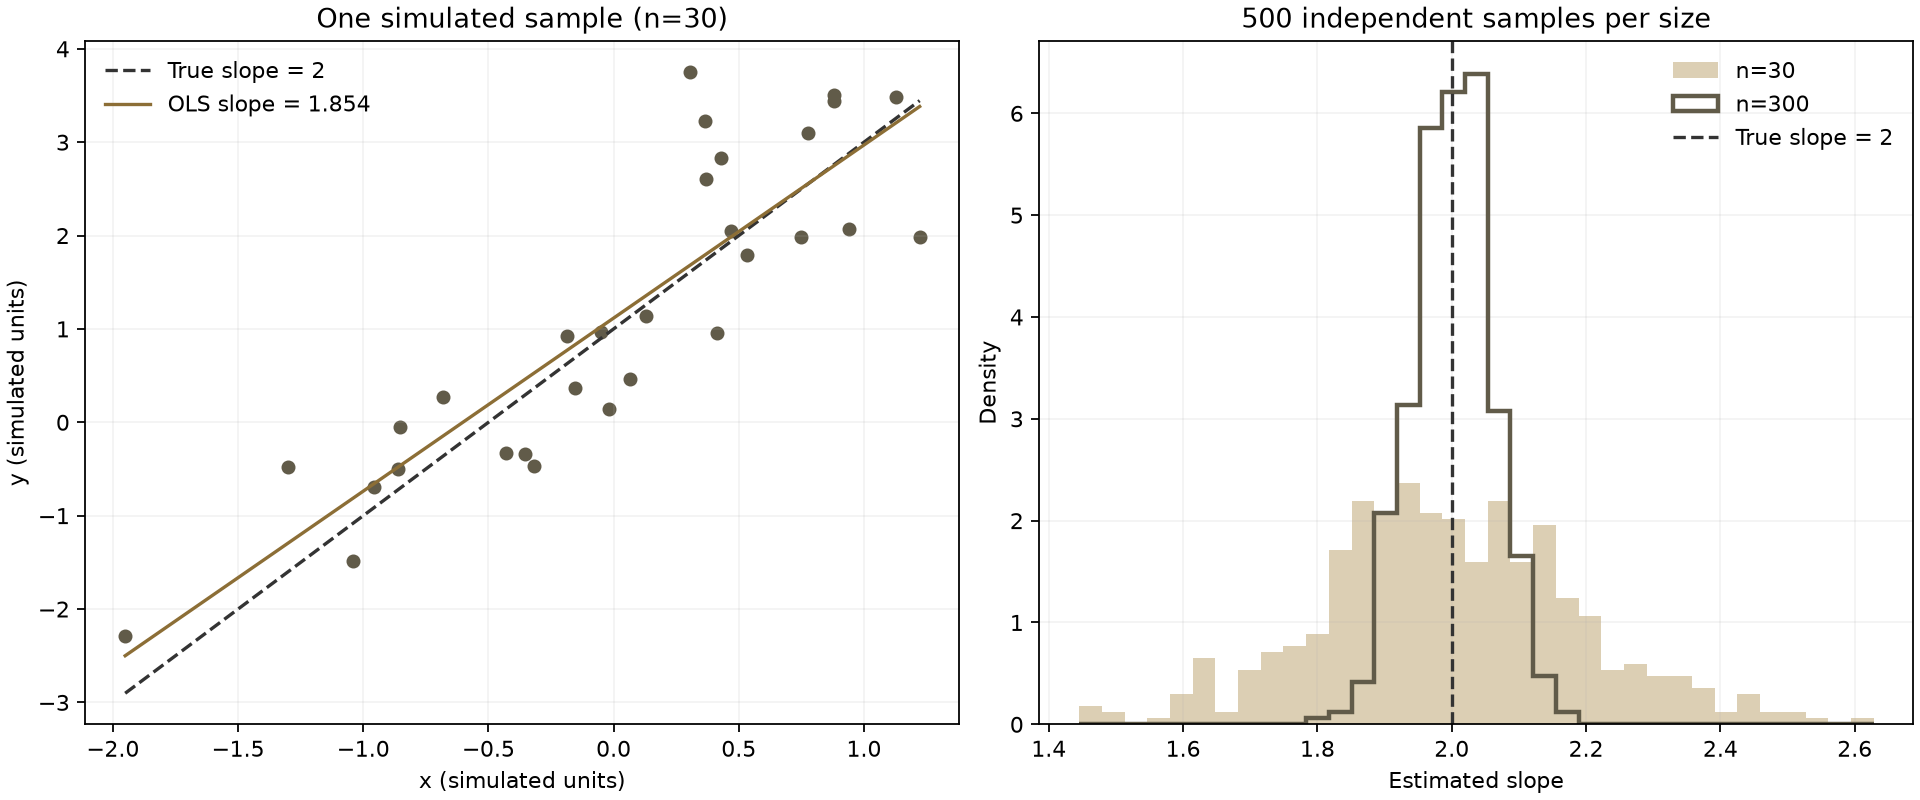
用已知真值的模拟模型,比较一次估计与不同样本量的重复抽样。查看实际分布、1000 个抽样系数及结果摘要,下载 Python、模拟数据和图,改变种子继续观察。
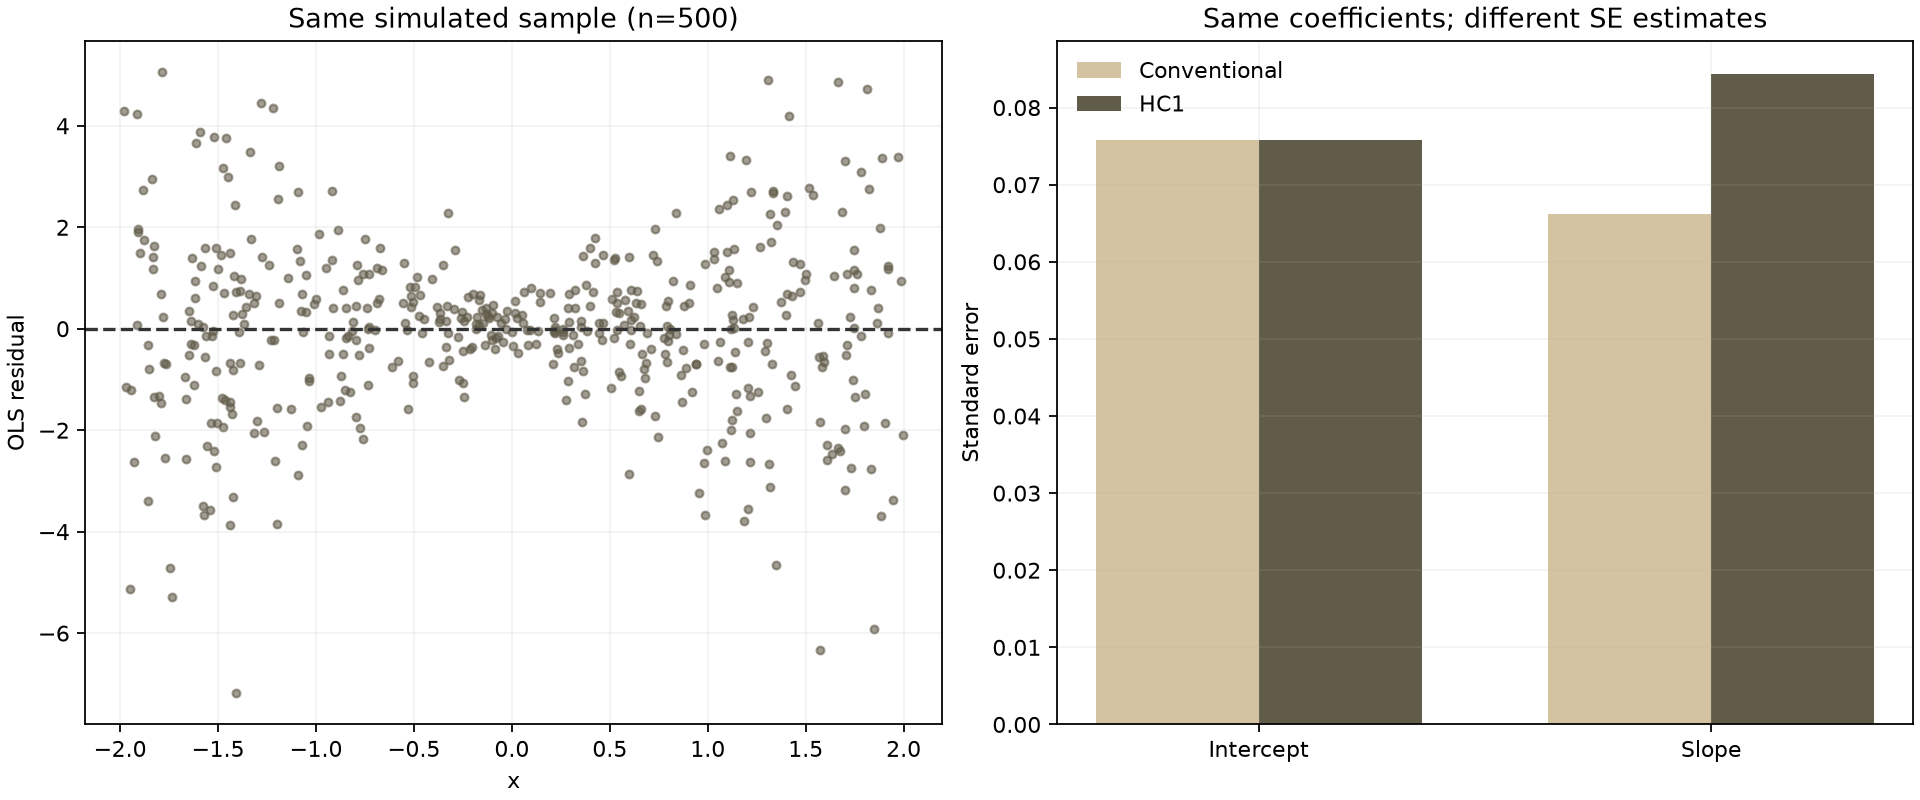
固定同一模拟样本和 OLS 系数,比较普通与 HC1 标准误、区间和 p 值。查看 Python 与 Stata 的独立实算对照,下载数据、代码、实际日志和复做说明。
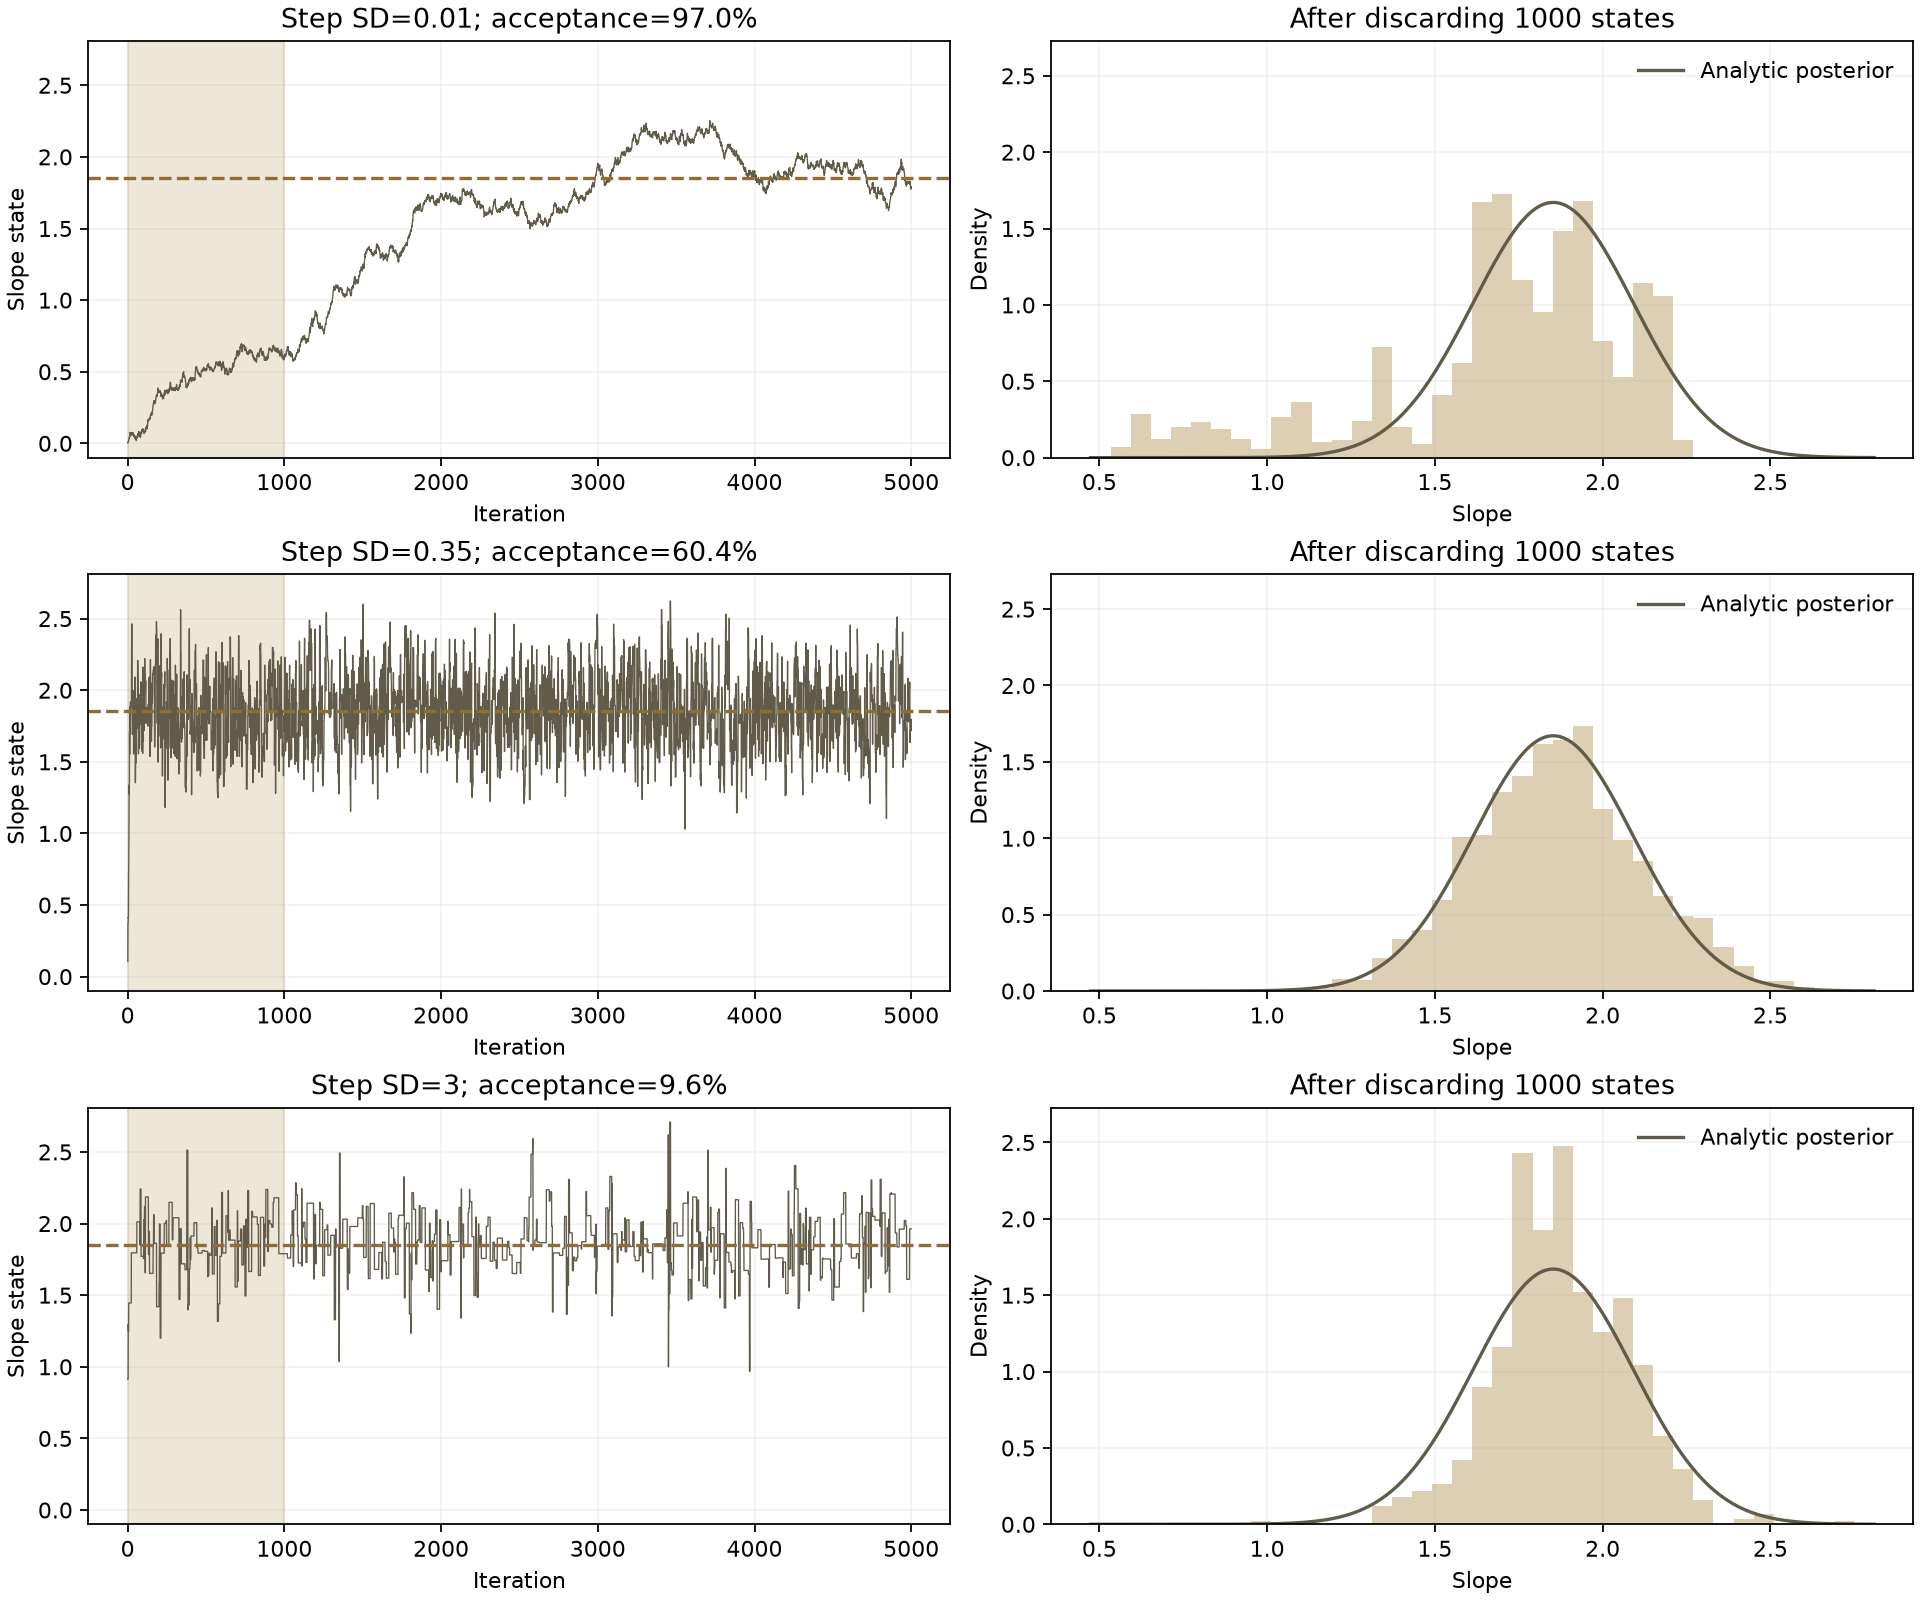
围绕同一解析后验目标,比较三种提议步长的轨迹、接受率和保留状态分布。下载完整程序、15000 个状态及图,区分有限链表现与收敛判断。
回归表转 Word将相同样本的两个实际 Stata 回归整理成可编辑 Word 表格,核对系数、稳健标准误、样本量和表注。下载原生文档、CSV、代码及实际日志,按指南继续排版。
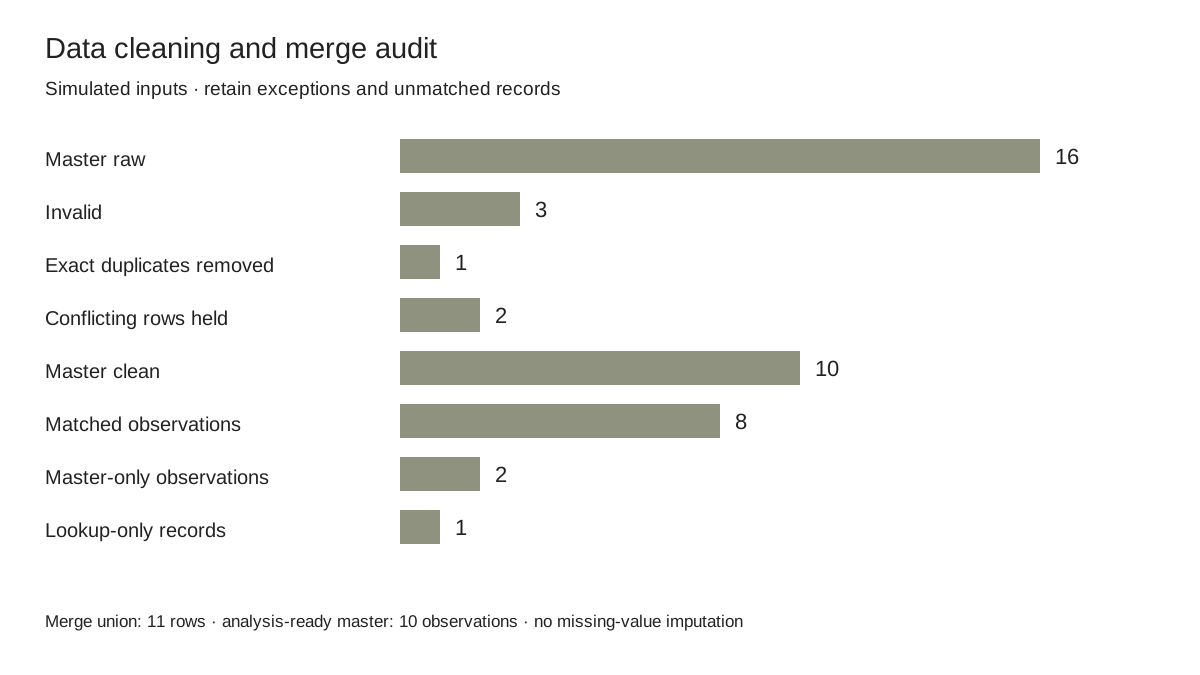
用自产模拟表检查无效字段、完全重复与键冲突,保留缺失和全部匹配状态。查看 Python 与 Stata 的独立实算,下载原输入、逐行审计、清洗成果和复做程序。