
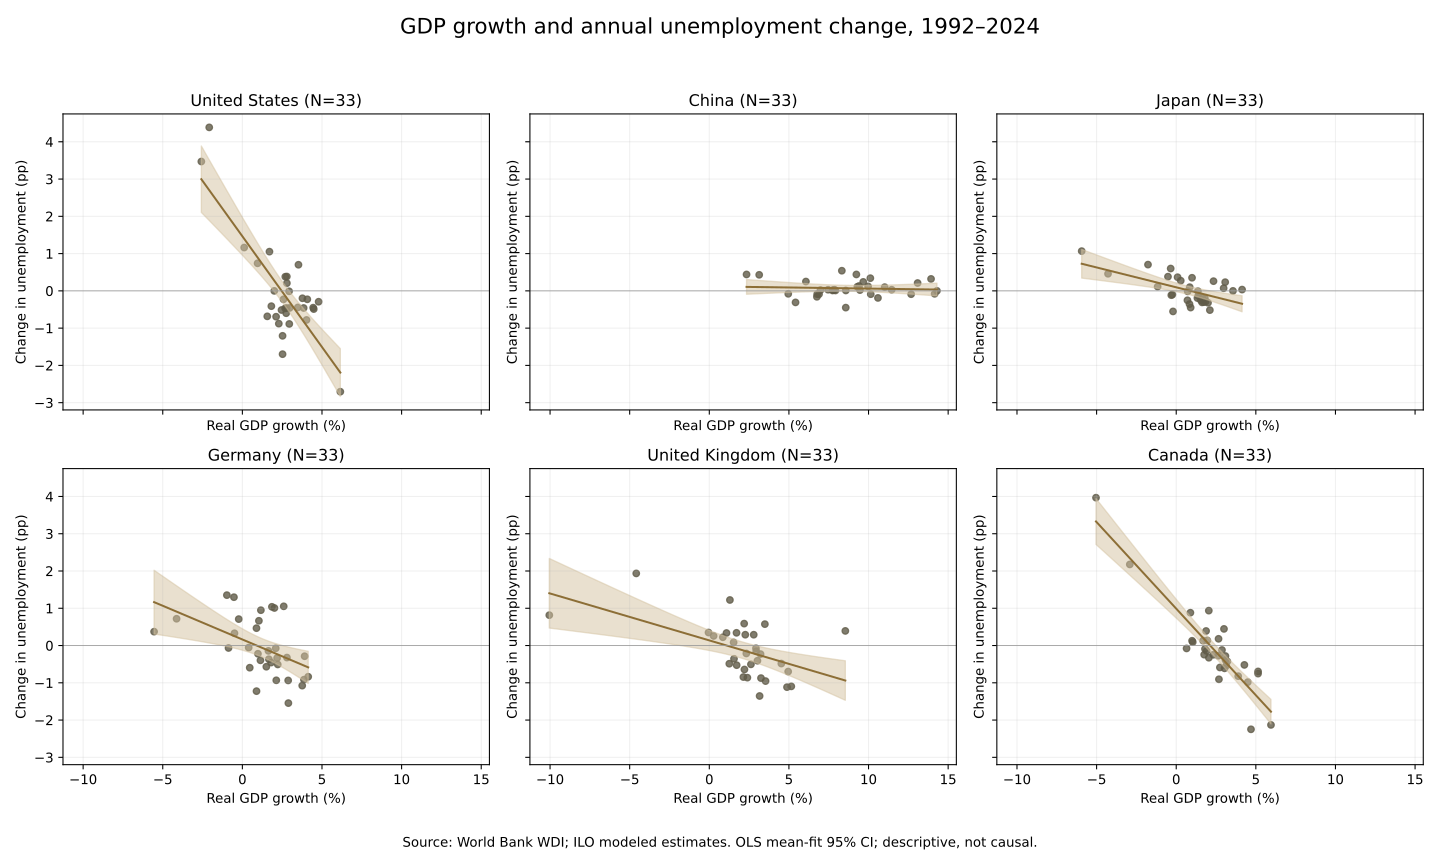
这份案例把一项公开数据任务完整展开:确定指标、保存来源、对齐国家与年份、计算失业率变化,再用图和回归查看关系。下面展示 Python 与 Stata 在同一公开数据快照上的实际计算结果,可以下载并独立复做。
起点:两个指标和六个国家
任务沿用原案例的美国、中国、日本、德国、英国和加拿大,获取 1991–2024 年的年度数据。GDP 指标是实际 GDP 年增长率 NY.GDP.MKTP.KD.ZG,单位为 %;失业率是占劳动力的比例 SL.UEM.TOTL.ZS,采用 ILO 模型估计口径。它不是各国新闻中公布的失业率的直接替代,来源本身包含模型估计和插补。
本次快照取得 204 个国家—年份行,两个指标均无空值。1991 年只为下一年的差分提供输入;实际作图与回归为 1992–2024 年,每国 33 个观测。我们没有另行填补缺失值。
处理:先算变化,再分别拟合
失业率年度变化 = 今年失业率 − 去年失业率,单位是百分点。横轴是当年实际 GDP 增长率,纵轴是失业率年度变化;逐国估计带截距的 OLS。程序检查连续年份,不把跨越缺失年份的差值当作年度变化,也不把六国混成一个共同斜率。
| 国家 | N | 斜率 | 常规标准误 | 95% 区间 | R² |
|---|---|---|---|---|---|
| 美国 | 33 | -0.594 | 0.080 | -0.758–-0.431 | 0.640 |
| 中国 | 33 | -0.006 | 0.014 | -0.034–0.022 | 0.006 |
| 日本 | 33 | -0.107 | 0.027 | -0.162–-0.051 | 0.334 |
| 德国 | 33 | -0.181 | 0.059 | -0.302–-0.060 | 0.230 |
| 英国 | 33 | -0.126 | 0.037 | -0.201–-0.051 | 0.276 |
| 加拿大 | 33 | -0.464 | 0.039 | -0.544–-0.385 | 0.819 |
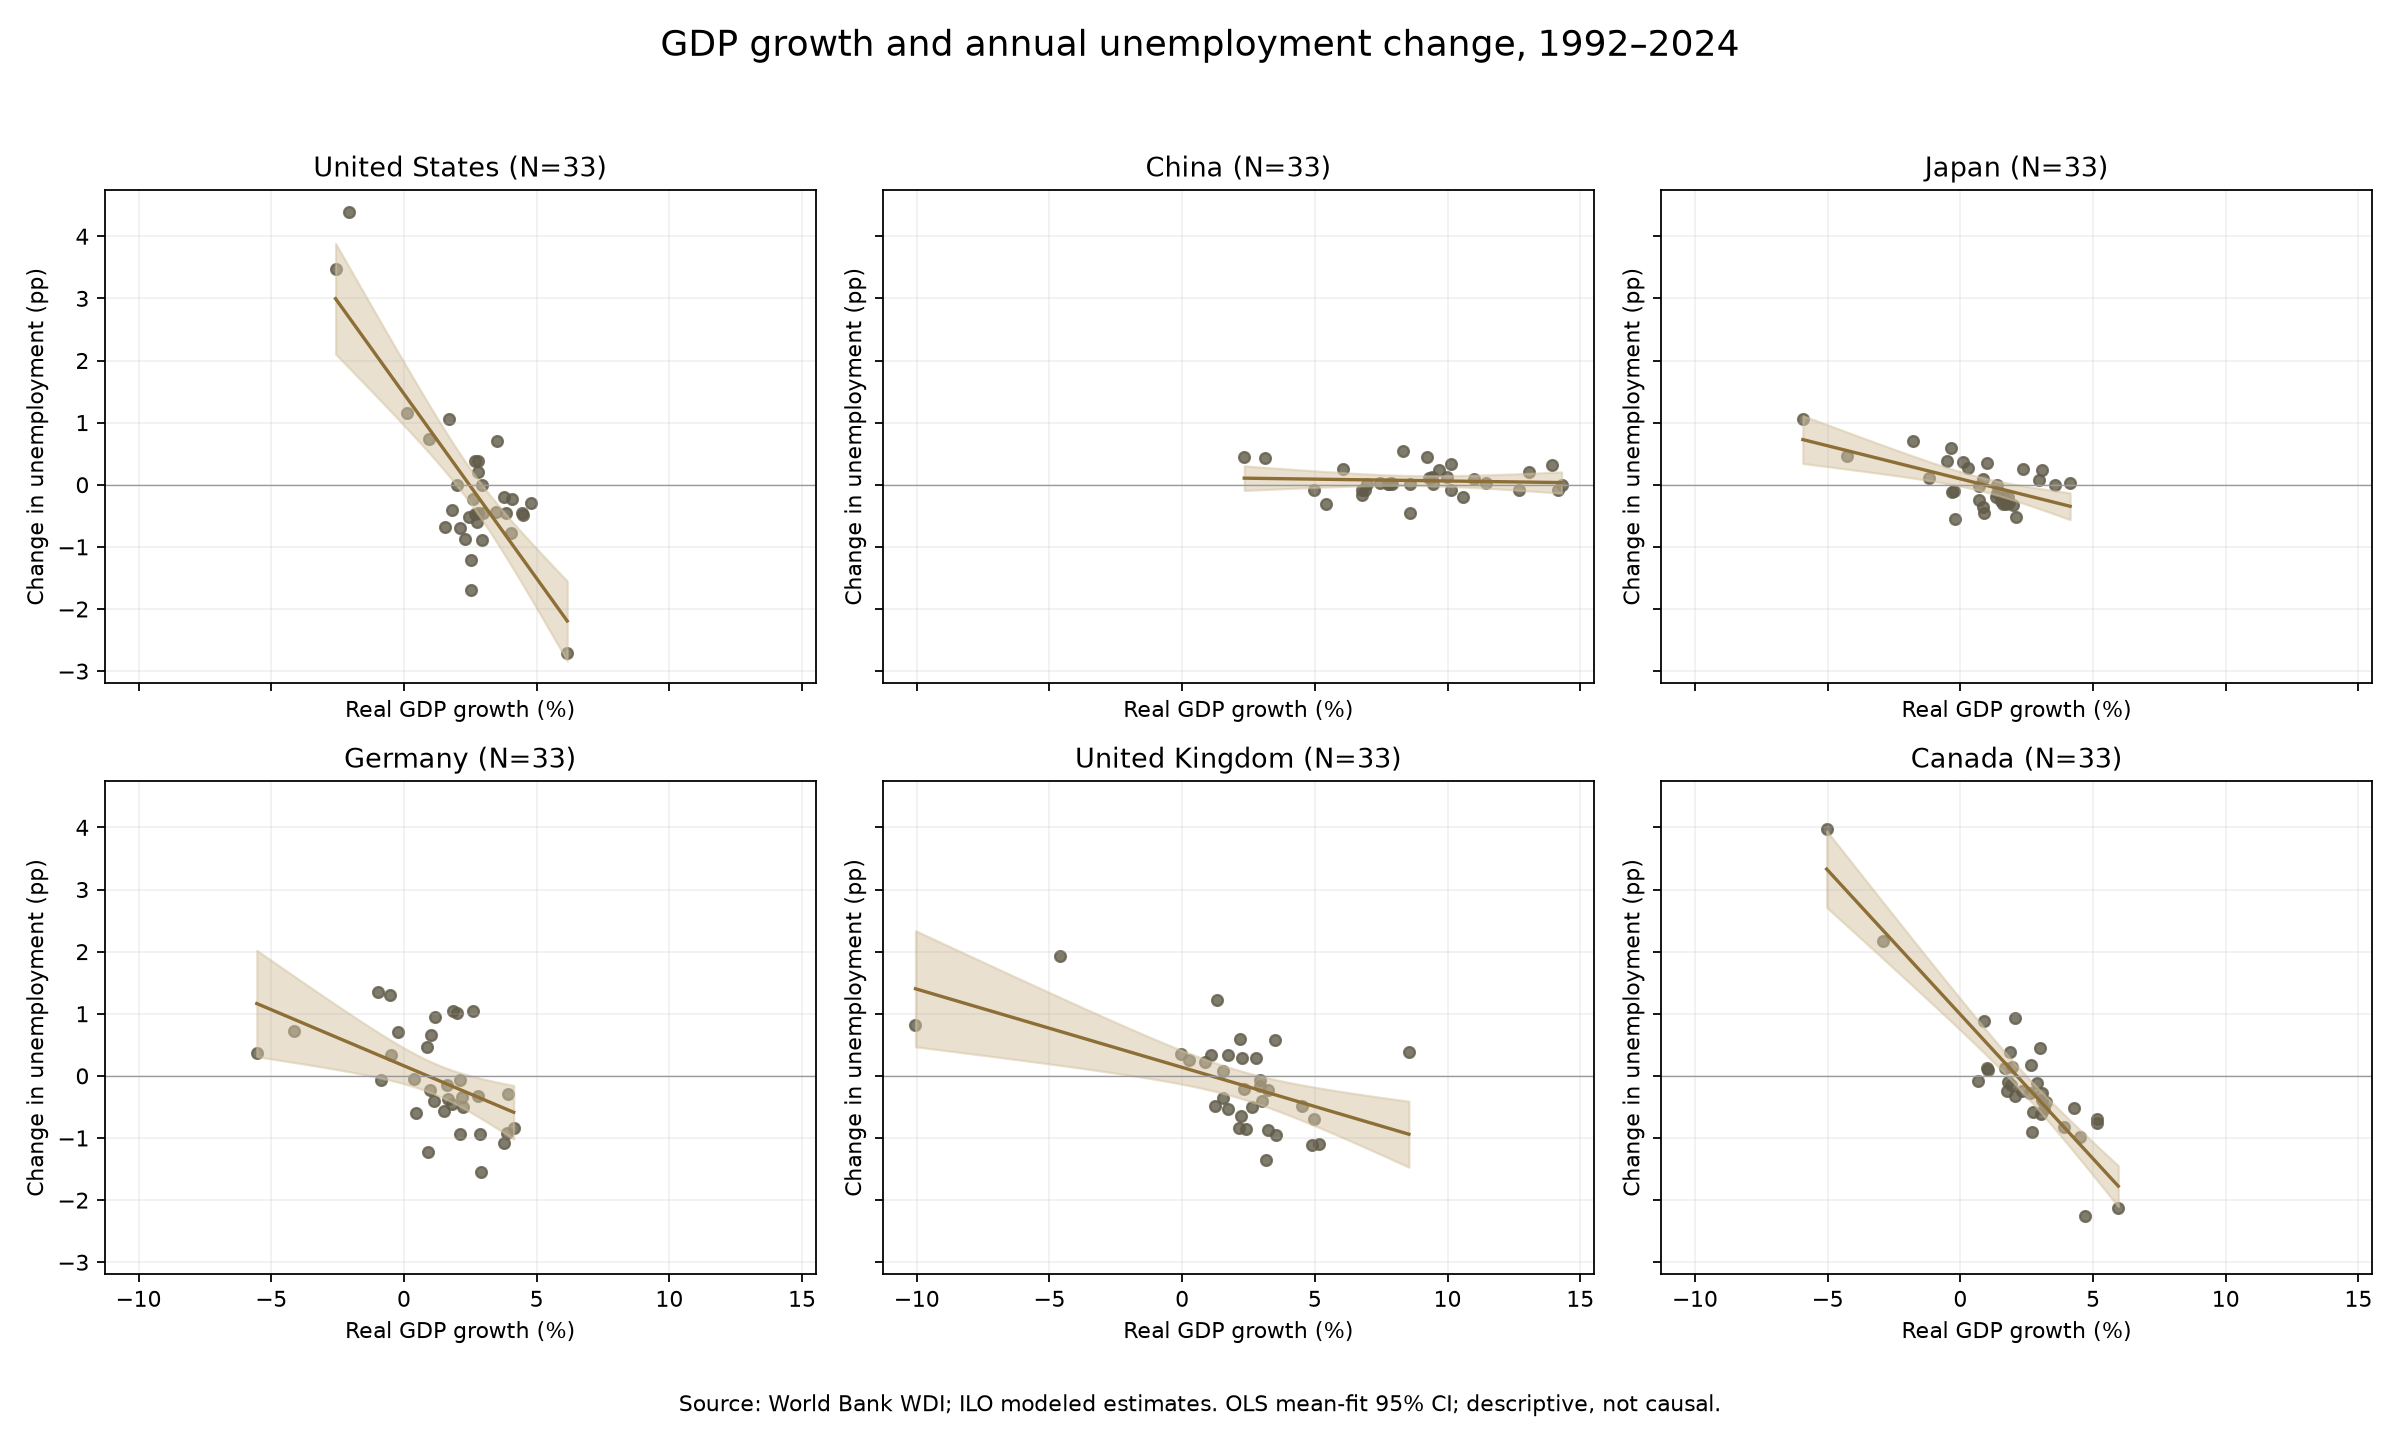
这份快照中,美国和加拿大的拟合负斜率较明显,中国的拟合线接近水平。美国约 −0.594 的斜率表示:在这组年度样本的线性拟合中,GDP 增长率相差 1 个百分点,对应的失业率年度变化相差约 −0.594 个百分点。它不表示提高增长率必然造成这种失业变化。
这里使用常规 OLS 标准误,没有调整年度序列的自相关、疫情异常点或结构变化;图和区间用于描述练习。来源方也提示模型插补值具有不确定性,不宜用于国家排名。正式研究还需检查统计口径、时期、滞后关系与推断设定,不能从六张图宣布定律在所有国家成立。
下载:数据、代码、图和实际输出
包内含原始 API JSON、整理后的 CSV、来源记录、Python 与 Stata 两套程序、两套实际成果及复做说明。数据来源为 World Bank WDI 与相应提供方,两项指标标示 CC BY 4.0;归属、修改说明及 World Bank 附加条款随包保留。本案例不代表来源机构的认可。
怎样复做?
- 解压到新的空目录,先保留一份原成果作对照。已有数据快照可直接离线计算,不需要 World Bank 账号。
- Python 按 README 准备依赖后,从包根目录运行 python python/analyze.py。Stata 在新的合法会话中切换到包根目录,运行 do stata/analysis.do;不需要 Python 或额外 Stata 命令。
- 核对六国、每国 33 个观测、1992–2024 年、差分单位和实际输出。两套实现已经独立对照,系数、标准误与区间的最大数值差小于 10⁻¹⁰;图形样式与文件字节不要求相同。
- 需要最新数据时,另复制一份包,显式运行 python fetch-data.py,再重跑分析。数据修订可能改变结果;比较时保留各次获取时间和原始响应。
分析程序会覆写练习目录内同名成果,Stata 的 clear all 会清空该会话的内存状态,请先保存当前工作。本次在 macOS、Python 3.11.11 与 Stata 19.5 运行;Windows 真机复做未覆盖。在 Marx Max 中尝试时,建立独立练习项目,检查实际程序和输出;云端 AI 会接收对话及工具返回内容。