
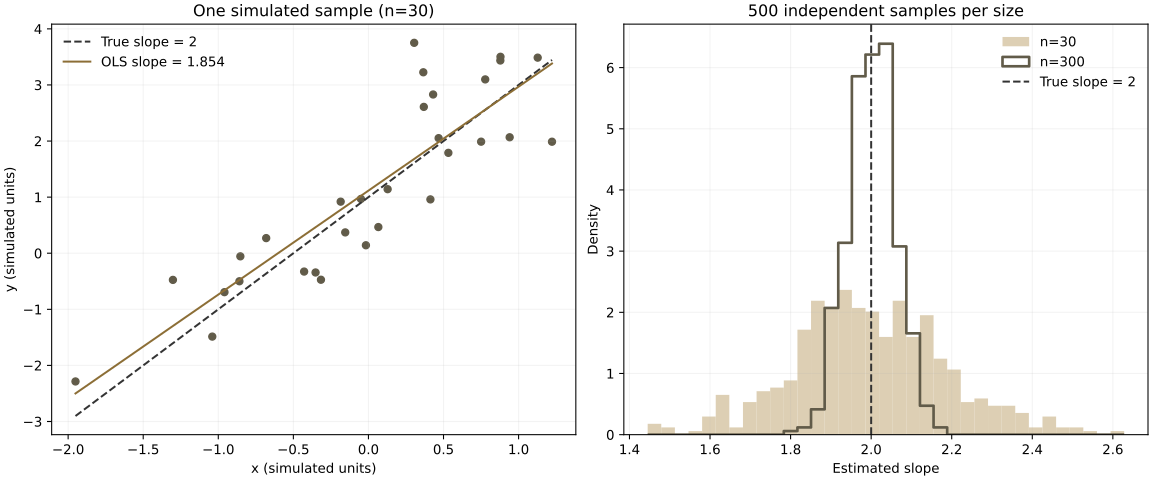
如果真实斜率是 2,一次回归为什么没有恰好估计出 2?这份教学案例用完全模拟的数据建立已知真值,再比较一次估计与重复抽样。所有图和数值来自配套程序实际运行,可以下载并改变种子继续观察。
保持什么不变,改变什么?
生成模型为 y = 1 + 2x + ε。x 和 ε 独立,均服从标准正态分布,各观测相互独立;截距真值为 1,斜率真值为 2。随机数种子为 42。分别以样本量 30 和 300 各抽取 500 个独立样本,并用 n=30 组的第一个样本展示一次 OLS。两种样本量的观察不是同一批数据的前缀,每次回归也不是反复使用同一张表。
一次估计与两种抽样分布
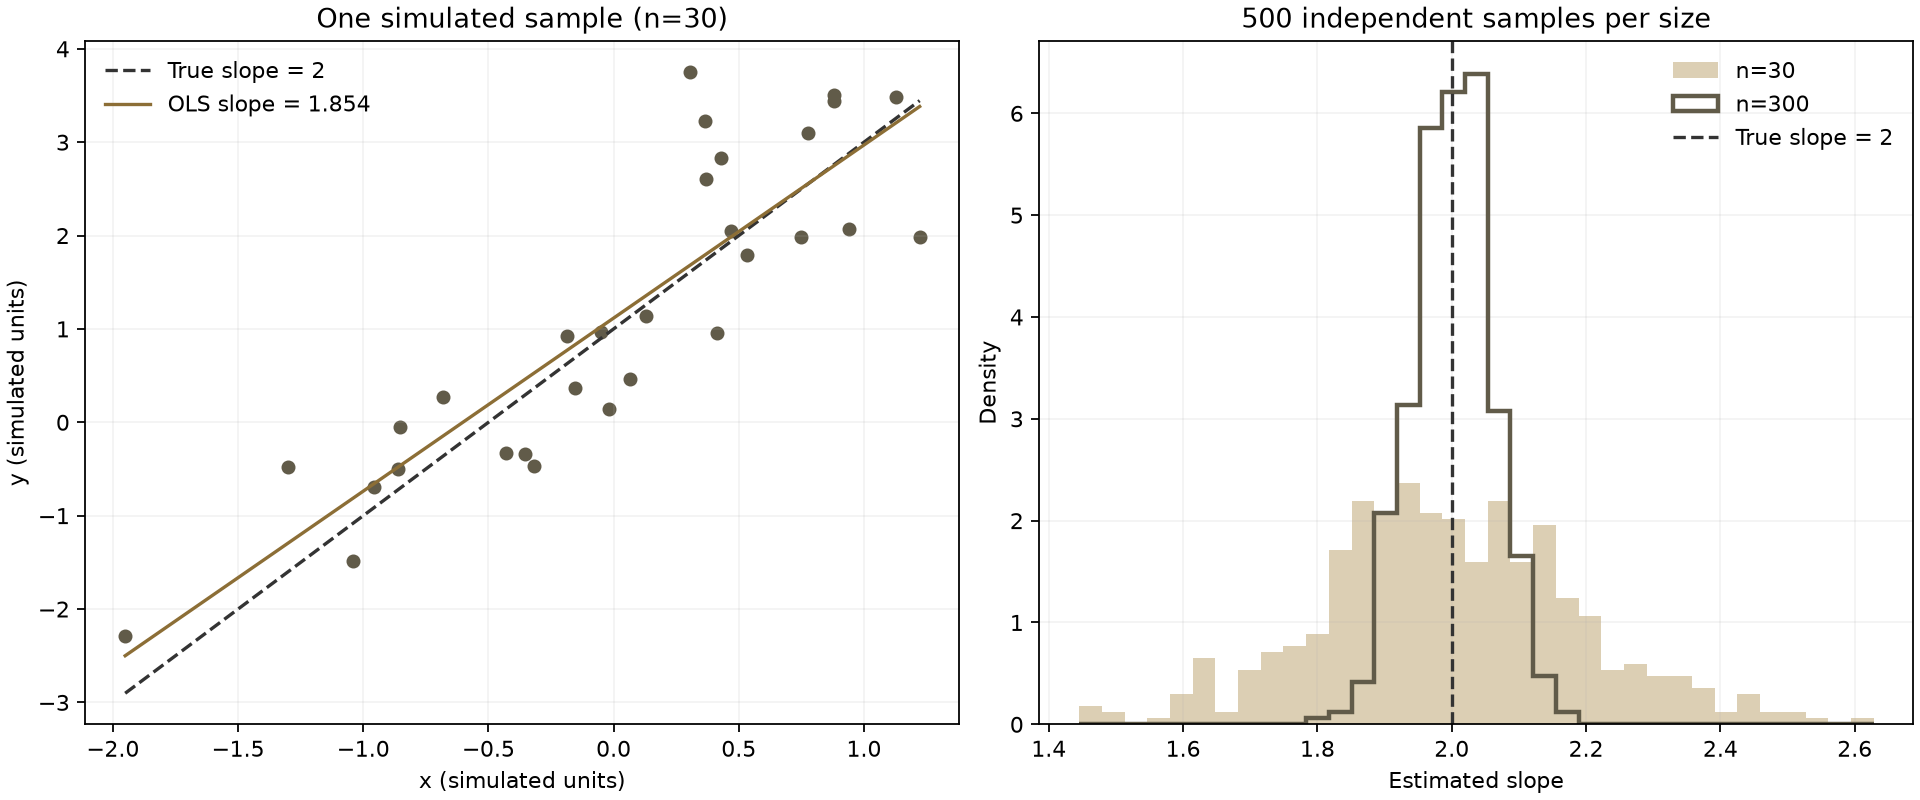
这一次 30 个观测的 OLS 截距约为 1.116,斜率约为 1.854。估计值偏离真值,并不单凭这一点说明程序或模型有误;检查程序后,再通过重复抽样观察估计的波动。
| 每次样本量 | 重复次数 | 斜率均值 | 抽样斜率标准差 | 经验 2.5%–97.5% 分位数 |
|---|---|---|---|---|
| 30 | 500 | 1.997 | 0.192 | 1.625–2.393 |
| 300 | 500 | 2.001 | 0.059 | 1.889–2.115 |
本次运行中,两组斜率均值都接近 2,n=300 的分布更集中。表里的标准差描述重复抽样系数的波动,不是某一次回归报告的标准误;经验分位数也不是那次回归的 95% 置信区间。不能据此说每个大样本估计都更接近真值。
这个结论对应本例独立、同方差、零条件均值的生成模型。增加样本量不能自动修复内生性、测量错误或错误模型,模拟也不证明真实研究的识别假设。
下载并复做
- 解压到新的练习目录,保留一份原成果作参考。按 README 准备 Python、NumPy 与 Matplotlib;安装依赖会访问软件源,分析本身离线。
- 运行 python analyze.py,检查完成标记、单样本 30 行、抽样系数 1000 行及两组摘要。同一参数和依赖环境应重现数值,图片字节不要求相同。
- 先只改种子,再增加重复次数,将练习输出指定到新的目录。比较单次估计和分布;增加重复次数与增加每次样本量是不同操作。
程序只生成模拟数据,默认覆写包内 results/ 的同名文件。已在 macOS、Python 3.11.11 实际运行与新目录复做,Windows 真机未覆盖。若在 Marx Max 中练习,使用单独项目,围绕实际源码和输出讨论;这个包不证明真人课堂效果或模型自动完成能力。