
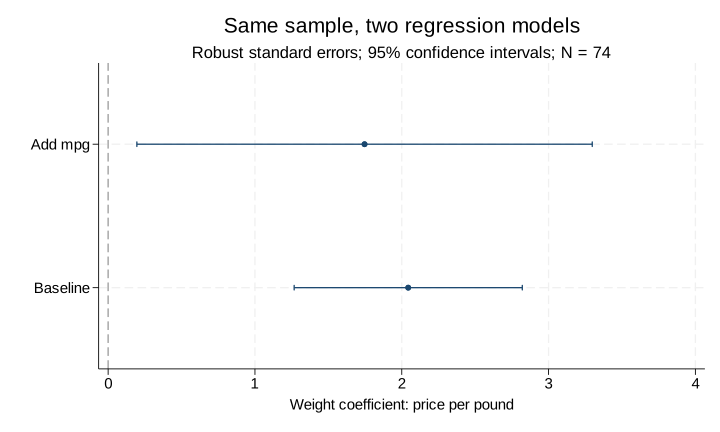
这份案例从指南中的第一次分析继续展开:先确定数据与样本,再比较两个设定,最后留下可复做的代码和结果。下面展示的是用 Stata 实际执行的计算示例,数据来自 Stata 自带的 auto;它用于练习模型比较,不是一项关于汽车价格的因果研究。
任务与运行条件
本次计算使用 Stata 19.5,不需要额外安装命令。两个模型都限制为 price、weight、mpg 非缺失的 74 个观测,使用 vce(robust)。已有合法 Stata 的读者可以下载程序,按下方步骤独立复做;在 Marx Max 中提出上面的任务时,仍应核对实际执行的代码和输出。
两个模型得到了什么?
| 模型 | weight 系数 | 稳健标准误 | 95% 置信区间 | N | R² |
|---|---|---|---|---|---|
| 仅 weight | 2.044 | 0.390 | 1.267–2.821 | 74 | 0.290 |
| 加入 mpg | 1.747 | 0.778 | 0.196–3.298 | 74 | 0.293 |
加入 mpg 后,weight 的系数从约 2.044 变为 1.747,稳健标准误变大,置信区间也更宽。两次样本量相同,因而本次变化不是由加入变量后减少观测造成的。但模型条件已经变化,不能直接把第二个模型称为更正确,也不能从这些结果推出重量对价格的因果效应。
下载代码与实际成果
包内包含完整 do-file、实际运行日志、两模型全部系数的 CSV、SVG 和 PNG 图,以及复做说明。不包含 Stata 软件或原始 auto 数据。
怎样复做并核对结果?
- 解压到一个新的空目录,避免与自己的研究文件混放。
- 在新的 Stata 练习会话中,将工作目录切换到解压目录,然后运行 do analysis.do。
- 检查日志有没有报错,确认两次回归都是 74 个观测、均采用稳健标准误,并比较 CSV 中的系数和区间。
- 若在 Marx Max 中尝试,先按使用指南确认连接,再在新的练习笔记本中运行完整程序;保留源码和输出,结果异常时从实际日志定位。
程序中的 clear 会替换内存数据,replace 会覆写练习目录内同名成果。请先保存正在进行的分析,再使用新会话和空目录。本次计算已在 macOS 的 Stata 19.5 运行;Windows 真机复做尚未覆盖。
换成自己的研究时,保留什么?
可以沿用“确定输入与样本 → 执行指定模型 → 检查实际输出 → 保存程序和成果”的顺序。数据路径、变量含义、控制变量与标准误需要根据研究重新确定,不能只把 auto 换成自己的文件就照搬结论。先从一段明确的任务开始,把原始材料、修改理由和结果对应关系留下来。