
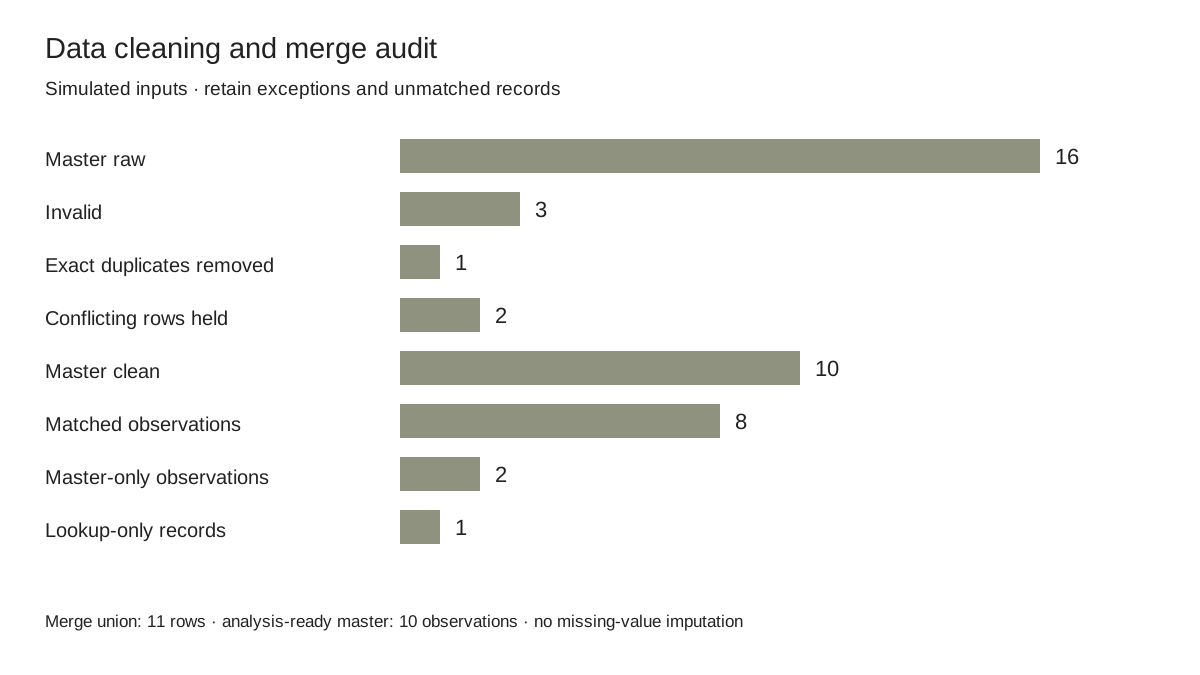
哪些记录进入了合并?
| 输入表 | 原始 | 无效 | 额外重复 | 冲突暂存 | 保留 |
|---|---|---|---|---|---|
| 企业年度主表 | 16 | 3 | 1 | 2 | 10 |
| 地区对照表 | 10 | 1 | 1 | 2 | 6 |
所有输入均自产模拟。按企业年度键和企业键分别检查,保留文本编号前导零,先隔离无效值,再移除额外完全重复;同键不同内容整组暂存。Python 和 Stata 独立执行后,数量、逐行状态、清洗数据和合并值一致。原始输入保持,缺失不填补。
合并 11 行,为什么主表仍是 10 条?
匹配成功 8 条,主表独有 2 条,对照表独有 1 条。merged-all.csv 保留三种状态;对照表独有记录没有主表年份,不算新增企业年度观测。analysis-ready.csv 保留清洗后的全部 10 条主表观测,含未匹配者,并保持一条 revenue 和一条 employees 缺失。
Python 仅需标准库,从包根运行 python clean_merge.py --output-dir rerun/python;独立 Stata 练习会话先创建 rerun,再运行 do clean_merge.do rerun/stata。保留参考结果,按来源行号和实际值核对;程序只解释本例规则,不替代真实研究的字段和样本判断。Windows 真机及模型自动执行未覆盖。