
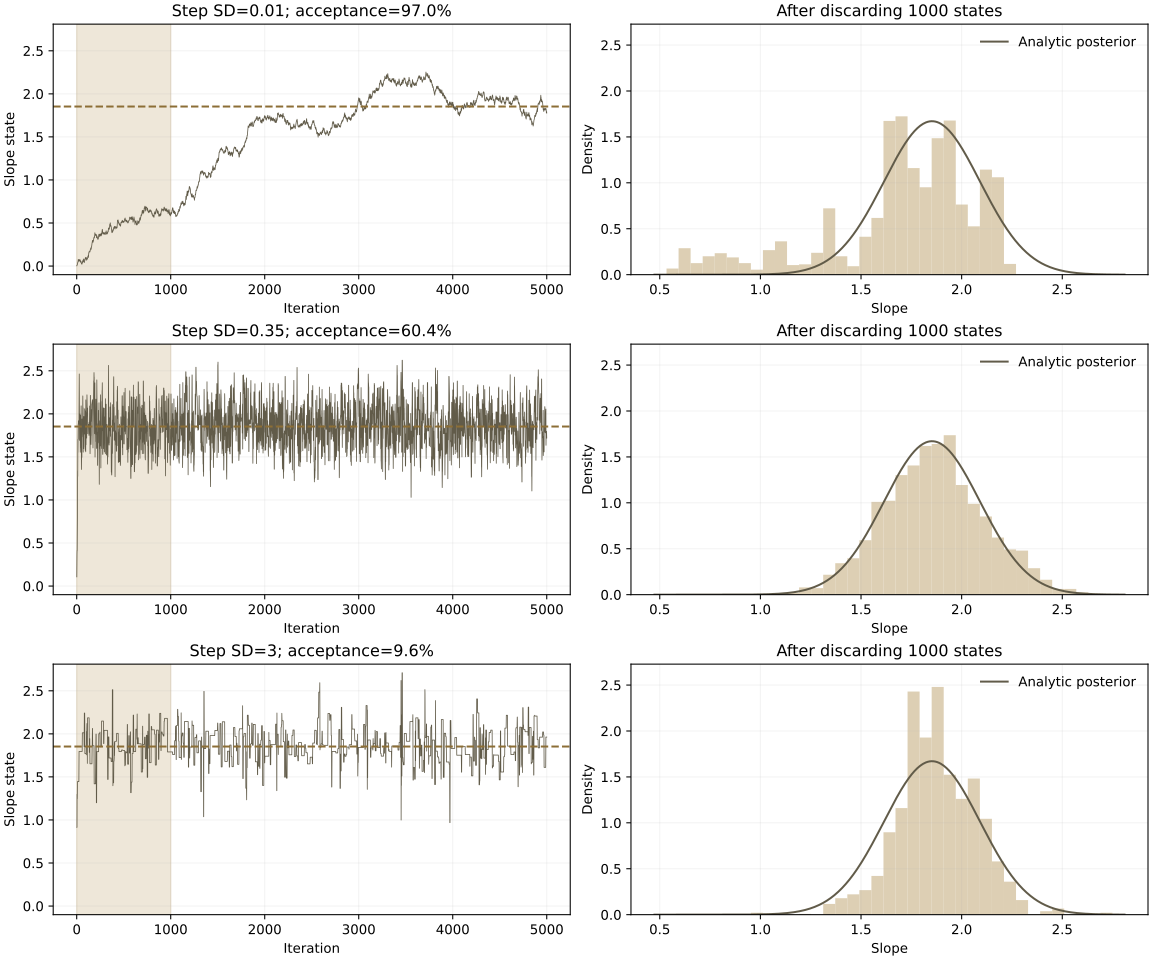
这份案例把“统计目标是什么”和“有限链是否充分探索”分开。数据完全模拟,目标后验有解析参照;配套程序实际运行三种提议步长,记录每一步状态与接受情况。
先固定数据和后验目标
30 个模拟观测来自 y=1+2x+ε,x 与 ε 独立标准正态,种子 42。推断模型固定截距为 1、误差标准差为 1,斜率先验为 N(0,5²)。它只推断一个斜率,不估计截距或方差。解析后验均值约 1.853,标准差约 0.239。
三种对称正态随机游走提议的标准差分别为 0.01、0.35、3,初值都为 0。每种设置运行 5000 次,比较时舍去前 1000 个状态,保留 4000 个。三种设置使用相同种子,不是独立的多链收敛诊断;没有将它们拼成一个后验样本。
| 提议标准差 | 全程接受率 | 保留状态均值 | 保留状态标准差 | 经验 2.5%–97.5% 分位数 |
|---|---|---|---|---|
| 0.01 | 97.0% | 1.696 | 0.381 | 0.683–2.187 |
| 0.35 | 60.4% | 1.862 | 0.252 | 1.381–2.362 |
| 3 | 9.6% | 1.872 | 0.199 | 1.465–2.236 |
小步长接受率约 97%,但本次保留状态均值约 1.696,偏离解析均值;大步长接受率约 9.6%,状态经常停留。0.35 的均值和分散程度较接近参照,但一次运行并不证明收敛。接受率按全部 5000 次计算,其他摘要按舍前 1000 后计算。
拒绝后必须保留前一个状态,而不是只导出接受点。舍去一段开头不保证收敛,经验分位数在探索不足时也不能当作可靠后验区间。正式分析需要适当的独立多链和有效样本量等诊断;这里不冒称已经完成这些诊断。 Stan 后验诊断说明
下载代码、数据和实际输出
- 解压到新目录并保留一份参考成果,按 README 准备 Python 依赖。安装依赖会访问软件源,分析本身离线。
- 从包根运行 python analyze.py,核对完成标记、数据行数和实际结果。默认覆写包内 results/ 同名文件。
- 按 README 指定新输出目录改变种子或运行长度。改变 seed 同时改变模拟数据与提议随机数;保持 seed 只增加迭代时,数据和后验不变。
本次在 macOS 使用 Python 3.11.11;异方差另用 Stata 19.5 独立核对,Windows 真机未覆盖。模拟仅用于说明方法与计算,不代表真实研究结果、真人教学效果或模型自动执行能力。